
Usando todos os núcleos: paralelismo no N.148i
Olá leitor, seja muito bem vindo de volta a mais uma etapa da nossa jornada aqui no Portal da Micilini! 😊
Este é o vigésimo quarto artigo da nossa série, e ele encerra a nossa empreitada de otimização.
Foram cinco artigos até aqui, e a gente explorou duas estratégias bem diferentes.
A primeira foi fazer menos trabalho, trocando algoritmos, guardando resultados que estavam sendo recalculados e evitando caminhos desnecessários. A segunda foi fazer mais por instrução, que é todo o assunto do SIMD.
Hoje entra a terceira, e talvez a mais óbvia de todas quando a gente para para pensar: usar mais de um núcleo. 🧵
O seu computador provavelmente tem quatro, oito ou mais núcleos disponíveis, e o nosso codec, até este momento, usa exatamente um deles.
Só que essa estratégia traz perguntas novas, e algumas respostas bem surpreendentes. Nem tudo dentro de um codec pode ser dividido, e eu vou mostrar exatamente o que não dá e por quê.
Também tem um caso que me deixou coçando a cabeça: uma máquina onde adicionar mais núcleos deixou o programa mais lento. 🤔
Sendo assim, pega o café que hoje fechamos uma boa parte dessa jornada! ☕
O que dá e o que não dá para dividir
Antes de escrever qualquer linha de código, vale fazer o exercício mais importante do paralelismo: olhar para cada etapa do codec e perguntar se ela pode ser quebrada em pedaços independentes.
A regra é simples de enunciar. Uma etapa pode ser dividida quando os pedaços não dependem uns dos outros.
Dito isso, nós vamos passar pelas etapas do encoder, tais como:
- Conversão de cor: cada pixel é convertido sozinho, sem olhar para os vizinhos. Dá para dividir numa boa. ✅
- Subsampling do croma: cada grupo de pixels vira uma amostra, também sem depender do resto. É possível fazer uma divisão aqui também. ✅
- DCT e quantização: cada bloco 8x8 é transformado isoladamente. Também é possível dividir. ✅
- Contagem de frequências: só somar ocorrências, e somas podem ser feitas em separado e juntadas depois. Divide, com isso precisa ser feito com cuidado. ⚠️
- Escrita dos bits: aqui a coisa muda de figura, não sendo possível uma divisão. ❌
Por que a escrita dos bits não divide?
Por dois motivos, e os dois são interessantes.
O primeiro é que o fluxo de bits é sequencial por natureza. Os códigos de Huffman têm tamanhos diferentes e não existe separador entre eles, então o segundo símbolo só pode ser escrito depois que o primeiro terminou. Não existe a noção de escrever no meio.
O segundo é mais sutil, e é aquela cadeia do DC que a gente montou lá no artigo 13. Cada bloco guarda a diferença entre o seu DC e o do bloco anterior, formando uma corrente onde cada elo depende do anterior.
bloco 0:  DC = 120        escreve 120
bloco 1:  DC = 123        escreve +3   (precisa saber do bloco 0)
bloco 2:  DC = 121        escreve -2   (precisa saber do bloco 1)
bloco 3:  DC = 121        escreve  0   (precisa saber do bloco 2)
Para calcular o que o bloco 3 escreve, é obrigatório conhecer o bloco 2. Isso é uma dependência real, e nenhuma esperteza de programação faz ela sumir. 🔗
No decoder a situação é a mesma, e por simetria: a leitura dos bits e a reconstrução da cadeia do DC também são sequenciais.
Dito isso, o nosso mapa fica assim:
PARALELIZÁVEL                    SEQUENCIAL
─────────────────────────────    ──────────────────────────
Conversão de cor (ida e volta)   Escrita dos bits
Subsampling do croma             Leitura dos bits
DCT e quantização                Cadeia do DC
Reconstrução final (upsampling)
Guarde bem essa divisão, porque ela vai explicar praticamente todos os resultados deste artigo.
Construindo o ajudante
Existem bibliotecas prontas para paralelismo, como o OpenMP, que resolvem isso com uma linha de comentário mágico. Só que a nossa série é sobre entender como as coisas funcionam por de baixo dos panos, e isso significa que vamos construir isso do zero 🤗
A boa notícia é que a nossa necessidade é bem específica e cabe numa função só. Todas as etapas paralelizáveis do codec têm o mesmo formato: percorrer um intervalo de linhas, fazendo a mesma coisa em cada uma.
A interface continua pequena, mas a implementação final precisa fazer duas coisas: dividir o intervalo e reaproveitar os trabalhadores entre uma etapa e outra:
// Number of workers used by the codec. The value can be changed by tests.
int  n148_thread_count(void);
void n148_set_thread_count(int count);

// Calls body(start, end, index, context) over [0, total) split into
// contiguous chunks, one per worker.
typedef void (*ParallelBody)(long start, long end, int worker, void *context);
void n148_parallel_for(long total, ParallelBody body, void *context);
Aquele void *context é o jeito clássico em C de passar dados arbitrários para uma função genérica. Quem chama monta uma estrutura com tudo que a tarefa precisa e passa o endereço dela.
Nos sistemas Unix o ajudante usa pthreads; no Windows, a contagem de núcleos usa a API nativa; e uma compilação com N148_NO_THREADS mantém exatamente a mesma interface rodando tudo na thread atual.
pthread_mutex_lock(&pool.dispatch_lock);
pool_initialize(workers - 1);
if (workers > pool.capacity + 1) workers = pool.capacity + 1;

pthread_mutex_lock(&pool.state_lock);
pool.total = total;
pool.participants = workers;
pool.remaining = workers - 1;
pool.body = body;
pool.context = context;
pool.generation++;
pthread_cond_broadcast(&pool.work_ready);
pthread_mutex_unlock(&pool.state_lock);

// The calling thread still owns worker zero.
body(0, total / workers, 0, context);

pthread_mutex_lock(&pool.state_lock);
while (pool.remaining != 0)
    pthread_cond_wait(&pool.work_done, &pool.state_lock);
pthread_mutex_unlock(&pool.state_lock);
pthread_mutex_unlock(&pool.dispatch_lock);
A thread que chamou continua pegando a primeira fatia em vez de ficar parada. As outras fatias são recebidas por trabalhadores que já estão dormindo no pool e acordam quando a geração da tarefa muda.
Com quatro trabalhadores, portanto, existem três threads de fundo e a thread chamadora. A diferença é que as três de fundo são criadas uma vez e reaproveitadas nas próximas conversões, transformadas e reconstruções. 💪
As threads não renascem a cada etapa
Uma primeira versão desse ajudante poderia chamar pthread_create e pthread_join a cada parallel_for. Ela estaria correta, mas o codec chama o ajudante muitas vezes, e criar o mesmo grupo de threads de novo em cada etapa aparece no perfil.
A versão final mantém um pool persistente. Cada trabalhador dorme numa variável de condição, observa a geração da tarefa e só toca na fatia cujo índice pertence à chamada atual:
static void *pool_worker(void *raw) {
    WorkerSlot *slot = (WorkerSlot *)raw;
    pthread_mutex_lock(&pool.state_lock);

    for (;;) {
        while (!pool.stopping && slot->generation == pool.generation)
            pthread_cond_wait(&pool.work_ready, &pool.state_lock);
        if (pool.stopping) break;

        slot->generation = pool.generation;
        int index = slot->index;
        if (index >= pool.participants) continue;

        long start = pool.total * index / pool.participants;
        long end = pool.total * (index + 1) / pool.participants;
        ParallelBody body = pool.body;
        void *context = pool.context;

        pthread_mutex_unlock(&pool.state_lock);
        body(start, end, index, context);
        pthread_mutex_lock(&pool.state_lock);

        if (--pool.remaining == 0)
            pthread_cond_signal(&pool.work_done);
    }
    pthread_mutex_unlock(&pool.state_lock);
    return NULL;
}
O dispatch_lock garante que duas chamadas não publiquem trabalhos diferentes no mesmo pool. Já state_lock, work_ready e work_done formam a barreira entre quem publicou a tarefa e quem terminou as fatias.
A quantidade de trabalhadores também deixou de ser uma constante escondida na compilação. O benchmark pode chamar n148_set_thread_count e repetir o mesmo binário com um, dois, quatro ou mais trabalhadores; o valor é limitado a 32 e N148_NO_THREADS força um.
int n148_thread_count(void) {
    if (configured == 0) {
        configured = detect_cores();
        if (configured < 1) configured = 1;
        if (configured > N148_MAX_THREADS) configured = N148_MAX_THREADS;
    }
    return configured;
}

void n148_set_thread_count(int count) {
    if (count < 1) count = 1;
    if (count > N148_MAX_THREADS) count = N148_MAX_THREADS;
#ifdef N148_NO_THREADS
    count = 1;
#endif
    configured = count;
}
Quando dividir não vale a pena
Criar uma thread não é de graça. O sistema operacional precisa alocar pilha, registrar a thread e agendar sua execução. O pool paga esse preço apenas na primeira chamada, mas acordar trabalhadores, publicar a tarefa e esperar uma barreira também têm custo.
Esse custo é pequeno para uma imagem grande, mas pode ser mais caro que o próprio trabalho para um intervalo curto. Por isso ainda precisamos de um caminho inline, mesmo depois de adotar o pool.
Então vale uma proteção logo na entrada:
    // Very small jobs are not worth the handover cost.
    if (workers <= 1 || total < 8) {
        body(0, total, 0, context);
        return;
    }
Se só existe um trabalhador, ou se o intervalo é minúsculo, a função executa direto na thread atual, sem acordar o pool. Assim o mesmo código serve para a máquina de um núcleo, para testes determinísticos e para uma compilação sem threads.
Aplicando nas três etapas
Com o ajudante pronto, aplicar nas etapas paralelizáveis vira quase mecânico. Pega o laço que já existia, transforma o corpo dele numa função, e chama o parallel_for.
Na conversão de cor do encoder, por exemplo:
    {
        // Each row is independent, so the conversion is split across
        // workers. On a single core this runs inline with no overhead.
        ColorJob job;
        job.rgb = image->pixels; job.y = y->data;
        job.cb = cb_full; job.cr = cr_full; job.width = width;
        n148_parallel_for(height, color_rows, &job);
    }
Na transformada, a divisão acontece por faixas de blocos, e cada trabalhador cuida de algumas linhas de blocos:
// Handles one horizontal band of blocks. Bands never overlap, so the
// workers write to disjoint slices of the output buffer.
static void quantize_rows(long start, long end, int worker, void *context) {
Aquele comentário aponta a propriedade que torna tudo isso seguro: as faixas não se sobrepõem. Cada trabalhador escreve numa parte diferente do buffer, então ninguém pisa no pé de ninguém e não é preciso nenhum tipo de trava.
Isso é o padrão ideal de paralelismo, e tem até nome: embarrassingly parallel, ou paralelismo constrangedoramente fácil. Quando o problema tem esse formato, dá para dividir sem sincronização nenhuma. 🎯
O caso que exige cuidado: contar frequências
Tem uma etapa que quase divide de graça, mas não totalmente.
A contagem de frequências dos símbolos, que alimenta a construção das tabelas de Huffman, é uma soma. E somas são associativas, então em tese dá para contar em pedaços e juntar no final.
O problema aparece se dois trabalhadores tentarem incrementar o mesmo contador ao mesmo tempo. O resultado disso é imprevisível, porque incrementar não é uma operação atômica: envolve ler, somar e gravar, e duas threads podem ler o mesmo valor antes de qualquer uma gravar alguma coisa.
A saída é dar a cada trabalhador o seu próprio conjunto de contadores, e somar tudo no final:
typedef struct {
    /* ... */
    long (*ac_freq)[256];            // one row per worker, merged later
} QuantJob;
Cada trabalhador escreve só na sua linha da tabela, sem disputa nenhuma. Quando todos terminam, uma passada rápida soma as linhas.
Essa técnica se chama redução, e ela aparece o tempo todo em computação paralela: em vez de compartilhar um acumulador, cada um acumula o seu e a combinação acontece no fim, uma vez só. 🧮
As últimas afiadas
Antes de medir o paralelismo, vale registrar que este artigo também traz um punhado de otimizações menores, aplicando técnicas que a gente já aprendeu em pontos que ainda não tinham sido visitados.
Nenhuma delas é uma ideia nova, e é exatamente por isso que estão agrupadas aqui:
- Blocos quase vazios no decoder: caminhos diretos para DC puro e para um, dois ou três coeficientes AC.
- Descritores esparsos: o retorno de
decode_blockdiz ao chamador qual reconstrução usar sem criar outra estrutura. - Upsampling vetorizado: a mistura 9:3:3:1 processa dezesseis amostras por vez.
- Conversão de cor com FMA: vermelho e azul usam multiplicação e soma fundidas quando a CPU oferece.
- Caminho fundido para 4:2:0: duas linhas são convertidas e reduzidas enquanto ainda estão no cache.
- Escrita de símbolos em lote: blocos esparsos escrevem direto e blocos densos agrupam tokens.
- Lookup Huffman de ações: código, amplitude, sinal, corrida, EOB e ZRL podem sair de uma única consulta.
- Reconstrução sem passadas inúteis: só coeficientes vivos são dequantizados; blocos DC e IDCTs densas escrevem direto no plano.
- Cache do encoder afinado: máscara AVX2, contagem de ACs e uma única alocação contígua.
- Reserva por bloco e dispatch único: verificações saem dos laços quentes do escritor e da DCT.
- Últimos cortes de tráfego: menos multiplicações no RGB→YCbCr e merge inline quando a imagem é pequena.
Todas seguem o mesmo espírito dos artigos anteriores, e juntas elas contribuem bastante para o resultado final.
Vamos ver cada uma delas com o código, porque no fim deste artigo o seu codec precisa estar idêntico ao do repositório.
Afiada 1: blocos quase vazios, em dct.c
No artigo 21 a gente criou um atalho para o bloco totalmente chapado, aquele onde só o DC sobreviveu à quantização. Naquele caso a reconstrução é uma cor sólida, e dá para pular a transformada inteira.
Só que existe uma faixa enorme de blocos logo ao lado desse caso: os que têm um, dois ou três coeficientes AC vivos. Em qualidade média eles são a maioria absoluta, e hoje pagam o preço de uma transformada completa.
Será que dá para "atalhar" esses também?
Dá, e a razão é boa, a transformada inversa é linear, ou seja, o resultado de vários coeficientes juntos é a soma dos resultados de cada um separadamente.
Então um bloco com um único coeficiente AC reconstrói como o nível do DC mais a contribuição daquele coeficiente sozinho. E essa contribuição tem uma forma bem específica, que dá para calcular de antemão.
Como a nossa transformada é separável (o que a gente vem usando desde o artigo 9), a contribuição de um coeficiente na posição vertical u e horizontal v é simplesmente o produto de duas respostas de uma dimensão: a resposta da frequência u multiplicada pela da frequência v.
Isso significa que basta guardar oito respostas de oito valores cada, uma para cada frequência, e todas as combinações saem dessas oito.
/* A separable inverse transform reconstructs a sparse block as the DC level
   plus one outer product per AC coefficient.  These are the exact one-pass
   AAN responses used by the full transform, kept as eight tiny basis rows. */
static void init_sparse_inverse_basis(void) {
    for (int frequency = 0; frequency < 8; frequency++) {
        float values[8] = {0};
        values[frequency] = 1.0f;
        idct_pass(values, 1);
        memcpy(sparse_inverse_basis[frequency], values, sizeof(values));
    }
}
Repara como essa tabela é construída: para cada frequência, a gente monta um vetor com um único 1 na posição dela, passa pela transformada inversa de uma dimensão que já temos, e guarda o resultado. É a própria idct_pass do artigo 19 sendo usada para gerar a tabela. 🎯
Com as oito respostas na mão, reconstruir um bloco de um coeficiente AC vira uma conta curta:
__attribute__((target("avx2")))
void idct_block_store_single_avx2(float dc, float ac, int index,
                                  unsigned char *dst, int stride) {
    int vertical_frequency = index >> 3;
    int horizontal_frequency = index & 7;
    __m256 horizontal =
        _mm256_loadu_ps(sparse_inverse_basis[horizontal_frequency]);
    const __m256 dc_vector = _mm256_set1_ps(dc);
    const __m256 shift = _mm256_set1_ps(128.0f);
    const __m256 round = _mm256_set1_ps(0.5f);
    for (int row = 0; row < 8; row++) {
        float vertical = ac * sparse_inverse_basis[vertical_frequency][row];
        __m256 value = _mm256_add_ps(
            dc_vector, _mm256_mul_ps(_mm256_set1_ps(vertical), horizontal));
        store_idct_row_avx2(value, dst + (long)stride * row, shift, round);
    }
}
Cada linha da saída é o nível do DC somado à resposta horizontal multiplicada por um fator vertical. São oito multiplicações vetoriais no total, contra as duas passadas completas da transformada.
Aqueles index >> 3 e index & 7 separam a posição do coeficiente em linha e coluna, aproveitando que o bloco tem oito colunas.
Para dois coeficientes a lógica é a mesma, apenas somando duas contribuições:
__attribute__((target("avx2")))
void idct_block_store_two_avx2(float dc,
                               float first_ac, int first_index,
                               float second_ac, int second_index,
                               unsigned char *dst, int stride) {
    int first_vertical = first_index >> 3;
    int second_vertical = second_index >> 3;
    __m256 first_horizontal =
        _mm256_loadu_ps(sparse_inverse_basis[first_index & 7]);
    __m256 second_horizontal =
        _mm256_loadu_ps(sparse_inverse_basis[second_index & 7]);
    const __m256 dc_vector = _mm256_set1_ps(dc);
    const __m256 shift = _mm256_set1_ps(128.0f);
    const __m256 round = _mm256_set1_ps(0.5f);
    for (int row = 0; row < 8; row++) {
        float first = first_ac * sparse_inverse_basis[first_vertical][row];
        float second = second_ac * sparse_inverse_basis[second_vertical][row];
        __m256 value = _mm256_add_ps(
            dc_vector, _mm256_mul_ps(_mm256_set1_ps(first), first_horizontal));
        value = _mm256_add_ps(
            value, _mm256_mul_ps(_mm256_set1_ps(second), second_horizontal));
        store_idct_row_avx2(value, dst + (long)stride * row, shift, round);
    }
}
E para três, mais uma:
__attribute__((target("avx2")))
void idct_block_store_three_avx2(float dc,
                                 float first_ac, int first_index,
                                 float second_ac, int second_index,
                                 float third_ac, int third_index,
                                 unsigned char *dst, int stride) {
    int first_vertical = first_index >> 3;
    int second_vertical = second_index >> 3;
    int third_vertical = third_index >> 3;
    __m256 first_horizontal =
        _mm256_loadu_ps(sparse_inverse_basis[first_index & 7]);
    __m256 second_horizontal =
        _mm256_loadu_ps(sparse_inverse_basis[second_index & 7]);
    __m256 third_horizontal =
        _mm256_loadu_ps(sparse_inverse_basis[third_index & 7]);
    const __m256 dc_vector = _mm256_set1_ps(dc);
    const __m256 shift = _mm256_set1_ps(128.0f);
    const __m256 round = _mm256_set1_ps(0.5f);
    for (int row = 0; row < 8; row++) {
        float first = first_ac * sparse_inverse_basis[first_vertical][row];
        float second = second_ac * sparse_inverse_basis[second_vertical][row];
        float third = third_ac * sparse_inverse_basis[third_vertical][row];
        __m256 value = _mm256_add_ps(
            dc_vector, _mm256_mul_ps(_mm256_set1_ps(first), first_horizontal));
        value = _mm256_add_ps(
            value, _mm256_mul_ps(_mm256_set1_ps(second), second_horizontal));
        value = _mm256_add_ps(
            value, _mm256_mul_ps(_mm256_set1_ps(third), third_horizontal));
        store_idct_row_avx2(value, dst + (long)stride * row, shift, round);
    }
}
A escrita usa um ajudante compartilhado, que converte uma linha de oito floats direto para bytes na saída:
__attribute__((target("avx2"), always_inline))
static inline void store_idct_row_avx2(__m256 value, unsigned char *dst,
                                        __m256 shift, __m256 round) {
    value = _mm256_add_ps(value, shift);
    value = _mm256_add_ps(value, round);
    __m256i i32 = _mm256_cvttps_epi32(value);
    __m128i i16 = _mm_packs_epi32(_mm256_castsi256_si128(i32),
                                  _mm256_extracti128_si256(i32, 1));
    _mm_storel_epi64((__m128i *)dst, _mm_packus_epi16(i16, i16));
}
A tabela precisa ser preenchida uma vez, na inicialização, então a declaração e a chamada entram junto das outras tabelas do módulo:
static float sparse_inverse_basis[8][8];
static void init_sparse_inverse_basis(void);
Vale a pena? Vale, e por um motivo simples: em qualidade 50, mais da metade dos blocos de uma imagem típica cai em algum desses casos. É a maioria do trabalho evitando o caminho caro. 🎉
Afiada 2: como o decoder avisa qual atalho usar
Os atalhos existem, mas alguém precisa decidir qual usar, e essa decisão acontece durante a decodificação de cada bloco.
O detalhe é que a função que decodifica já retornava um valor, o nível chapado do bloco. Criar um segundo canal de retorno complicaria a interface, então a solução foi empacotar a informação num inteiro.
A convenção final ficou assim: um retorno positivo já é o byte de um bloco chapado mais um; zero pede a transformada completa; e um retorno negativo carrega quais coeficientes sobreviveram para selecionar um dos atalhos esparsos.
#define SPARSE_TWO_BASE   64
#define SPARSE_THREE_BASE (64 + 4096)

/* Returns the flat byte value plus one for a DC-only block, zero for the full
   transform, or a negative sparse descriptor. Sparse descriptors pack one,
   two or three six-bit natural-order indices into disjoint integer ranges. */
Empacotar três posições de seis bits cada dentro de um inteiro é o mesmo tipo de truque que a gente usou no artigo 13, quando juntou o comprimento da corrida e o tamanho do coeficiente num único símbolo. Aqui são deslocamentos de 6 e 12 bits:
if (nonzero_ac == 1) return -single_ac_index;
if (nonzero_ac == 2)
    return -(SPARSE_TWO_BASE +
             (single_ac_index << 6) + second_ac_index);
if (nonzero_ac == 3)
    return -(SPARSE_THREE_BASE + (single_ac_index << 12) +
             (second_ac_index << 6) + third_ac_index);
return 0;
E do outro lado, quem recebe desempacota e chama a função certa:
                int sparse = -flat;
                if (sparse >= SPARSE_THREE_BASE) {
                    /* ...três coeficientes... */
                } else if (sparse >= SPARSE_TWO_BASE) {
                    /* ...dois coeficientes... */
                } else {
                    /* ...um coeficiente... */
                }
É uma técnica que aparece bastante em código de baixo nível, e ela tem um custo: a interface fica menos óbvia de ler. Por isso o comentário em cima da função é obrigatório, e não opcional. 📝
Afiada 3: upsampling vetorizado, em decoder.c
No artigo 21 a gente descobriu que os pesos do upsampling de croma são sempre os mesmos, aquela combinação 9:3:3:1, e trocou a fórmula genérica por aritmética inteira.
Aquilo já foi um salto grande, porém o laço continuou processando uma amostra por vez. Com o SIMD que a gente aprendeu nos artigos 22 e 23, dá para fazer dezesseis de uma vez.
A primeira metade é a mistura vertical das duas linhas de croma, que é direta:
#if defined(__x86_64__) || defined(__i386__)
// Vertical blend of two chroma rows, sixteen samples per pass.
__attribute__((target("avx2")))
static void blend_rows_avx2(const unsigned char *near_row,
                            const unsigned char *far_row,
                            int count, unsigned short *out) {
    const __m256i three = _mm256_set1_epi16(3);
    int x = 0;
    for (; x + 16 <= count; x += 16) {
        __m256i n = _mm256_cvtepu8_epi16(_mm_loadu_si128((const __m128i *)(near_row + x)));
        __m256i f = _mm256_cvtepu8_epi16(_mm_loadu_si128((const __m128i *)(far_row  + x)));
        _mm256_storeu_si256((__m256i *)(out + x),
                            _mm256_add_epi16(_mm256_mullo_epi16(n, three), f));
    }
    for (; x < count; x++)
        out[x] = (unsigned short)(3 * near_row[x] + far_row[x]);
}
A segunda metade é o esticamento horizontal, e ela tem uma sutileza. Cada amostra de origem gera duas amostras de saída, uma usando o vizinho da esquerda e outra o da direita.
Calcular as duas é fácil, e o trabalho está em intercalar os resultados de volta na ordem certa:
// Horizontal stretch: every source sample produces the two outputs it
// dominates, so both are computed as vectors and interleaved back.
__attribute__((target("avx2")))
static void stretch_avx2(const unsigned short *src, int first, int last,
                         unsigned short *dst) {
    const __m256i three = _mm256_set1_epi16(3);
    int k = first;
    for (; k + 16 <= last; k += 16) {
        __m256i cur  = _mm256_loadu_si256((const __m256i *)(src + k));
        __m256i prev = _mm256_loadu_si256((const __m256i *)(src + k - 1));
        __m256i next = _mm256_loadu_si256((const __m256i *)(src + k + 1));

        __m256i scaled = _mm256_mullo_epi16(cur, three);
        __m256i even = _mm256_add_epi16(scaled, prev);
        __m256i odd  = _mm256_add_epi16(scaled, next);

        __m256i lo = _mm256_unpacklo_epi16(even, odd);
        __m256i hi = _mm256_unpackhi_epi16(even, odd);
        _mm256_storeu_si256((__m256i *)(dst + 2*k),
                            _mm256_permute2x128_si256(lo, hi, 0x20));
        _mm256_storeu_si256((__m256i *)(dst + 2*k + 16),
                            _mm256_permute2x128_si256(lo, hi, 0x31));
    }
    for (; k < last; k++) {
        int centre = src[k] * 3;
        dst[2*k]     = (unsigned short)(centre + src[k-1]);
        dst[2*k + 1] = (unsigned short)(centre + src[k+1]);
    }
}
Aquele par unpacklo e unpackhi intercala os valores, e o permute2x128 corrige a ordem entre as duas metades do registrador. É o mesmo cuidado com metades que a gente viu no artigo 23, quando o empacotamento precisou de um embaralhamento extra.
Afiada 4: conversão de cor com FMA, em decoder.c
Existe uma instrução que faz multiplicação e soma numa operação só, chamada de fused multiply-add, ou FMA.
Ela não é apenas mais rápida por juntar duas operações. Ela também é mais precisa, porque não arredonda o resultado intermediário da multiplicação antes de somar.
A conversão de cor é cheia de padrões do tipo multiplica e soma, então ela se beneficia direto:
__attribute__((target("avx2,fma"), always_inline))
static inline void convert_ycbcr8_fma(const unsigned char *luma,
                                      __m128i blue, __m128i red,
                                      unsigned char *out) {
    const __m256 inv    = _mm256_set1_ps(1.0f / (1 << CHROMA_SHIFT));
    const __m256 half   = _mm256_set1_ps(128.0f);
    const __m256 k_r_cr = _mm256_set1_ps(1.402f);
    const __m256 k_b_cb = _mm256_set1_ps(1.772f);

    __m128i y8 = _mm_loadl_epi64((const __m128i *) luma);
    __m256 yf  = _mm256_cvtepi32_ps(_mm256_cvtepu8_epi32(y8));
    __m256 cbf = _mm256_sub_ps(
        _mm256_mul_ps(_mm256_cvtepi32_ps(_mm256_cvtepu16_epi32(blue)), inv), half);
    __m256 crf = _mm256_sub_ps(
        _mm256_mul_ps(_mm256_cvtepi32_ps(_mm256_cvtepu16_epi32(red)), inv), half);

    __m256 rf = _mm256_fmadd_ps(crf, k_r_cr, yf);
    __m256 bf = _mm256_fmadd_ps(cbf, k_b_cb, yf);
    finish_ycbcr8_avx2(yf, cbf, crf, rf, bf, out);
}
Como nem todo processador com AVX2 tem FMA, ele entra como um nível novo na detecção que a gente montou no artigo 22. Passa a existir um N148_CPU_AVX2_FMA acima do N148_CPU_AVX2, e o despacho escolhe o melhor disponível:
__attribute__((target("avx2,fma")))
static void ycbcr_row_fma(const unsigned char *luma,
                          const unsigned short *blue,
                          const unsigned short *red,
                          unsigned char *out, int count) {
    int i = 0;
    for (; i + 8 <= count; i += 8) {
        __m128i cb16 = _mm_loadu_si128((const __m128i *)(blue + i));
        __m128i cr16 = _mm_loadu_si128((const __m128i *)(red  + i));
        convert_ycbcr8_fma(luma + i, cb16, cr16, out + i * 3);
    }

    /* Keep the rare tail on the non-FMA implementation: fusing the green
       channel changes a handful of exact half-way rounding cases. */
    if (i < count)
        ycbcr_row_avx2(luma + i, blue + i, red + i,
                       out + i * 3, count - i);
}
Repara no comentário sobre o rabo do laço, que é um detalhe fino e honesto: como o FMA arredonda diferente, um punhado de casos exatamente no meio do caminho pode cair para o outro lado, e manter o rabo na versão sem FMA evita que a última fatia da linha divirja das demais. ⚖️
Afiada 5: o caminho fundido para 4:2:0, em ppm.c
Essa aqui é de uma natureza diferente das outras, porque não otimiza uma conta e sim o caminho dos dados.
Do jeito que estava, o encoder fazia duas viagens pela imagem inteira: primeiro convertia todos os pixels para YCbCr, gravando três planos completos na memória, e depois voltava para reduzir os planos de croma pela metade.
O problema é que uma imagem grande não cabe no cache. Então a segunda passada precisa buscar tudo de volta da memória principal, que é a parte lenta da hierarquia.
A saída é fundir as duas etapas: converter duas linhas e, com elas ainda quentes no cache, já produzir a linha de croma reduzida.
A redução de duas linhas em uma também virou vetorial:
#if defined(__x86_64__) || defined(__i386__)
__attribute__((target("avx2")))
static void downsample_420_rows_avx2(const unsigned char *cb0,
                                     const unsigned char *cb1,
                                     const unsigned char *cr0,
                                     const unsigned char *cr1,
                                     int width, unsigned char *out_cb,
                                     unsigned char *out_cr, int out_width) {
    const __m256i ones = _mm256_set1_epi8(1);
    const __m256i two = _mm256_set1_epi16(2);
    int x = 0;
    for (; x + 16 <= out_width && 2 * x + 32 <= width; x += 16) {
        int source = x * 2;
        __m256i cb_top = _mm256_loadu_si256((const __m256i *)(cb0 + source));
        __m256i cb_bottom = _mm256_loadu_si256((const __m256i *)(cb1 + source));
        __m256i cr_top = _mm256_loadu_si256((const __m256i *)(cr0 + source));
        __m256i cr_bottom = _mm256_loadu_si256((const __m256i *)(cr1 + source));
        __m256i cb_sum = _mm256_add_epi16(_mm256_maddubs_epi16(cb_top, ones),
                                          _mm256_maddubs_epi16(cb_bottom, ones));
        __m256i cr_sum = _mm256_add_epi16(_mm256_maddubs_epi16(cr_top, ones),
                                          _mm256_maddubs_epi16(cr_bottom, ones));
        cb_sum = _mm256_srli_epi16(_mm256_add_epi16(cb_sum, two), 2);
        cr_sum = _mm256_srli_epi16(_mm256_add_epi16(cr_sum, two), 2);
        __m128i cb_bytes = _mm_packus_epi16(_mm256_castsi256_si128(cb_sum),
                                            _mm256_extracti128_si256(cb_sum, 1));
        __m128i cr_bytes = _mm_packus_epi16(_mm256_castsi256_si128(cr_sum),
                                            _mm256_extracti128_si256(cr_sum, 1));
        _mm_storeu_si128((__m128i *)(out_cb + x), cb_bytes);
        _mm_storeu_si128((__m128i *)(out_cr + x), cr_bytes);
    }
    for (; x < out_width; x++) {
        int source = x * 2;
        int next = source + 1 < width ? source + 1 : width - 1;
        out_cb[x] = (unsigned char)((cb0[source] + cb0[next] +
                                     cb1[source] + cb1[next] + 2) >> 2);
        out_cr[x] = (unsigned char)((cr0[source] + cr0[next] +
                                     cr1[source] + cr1[next] + 2) >> 2);
    }
}
E o corpo do trabalhador processa o par de linhas de ponta a ponta:
static void color_420_rows(long start, long end, int worker, void *context) {
    (void)worker;
    Color420Job *job = (Color420Job *)context;
    int width = job->image->width;
    int height = job->image->height;

#define COLOR_STACK_WIDTH 2048
    _Alignas(32) unsigned char stack_rows[COLOR_STACK_WIDTH * 4];
    unsigned char *allocated = NULL;
    unsigned char *cb0;
    if (width <= COLOR_STACK_WIDTH) {
        cb0 = stack_rows;
    } else {
        allocated = (unsigned char *)malloc((size_t)width * 4);
        if (!allocated) {
#if defined(__GNUC__) || defined(__clang__)
            __atomic_store_n(&job->failed, 1, __ATOMIC_RELAXED);
#else
            job->failed = 1;
#endif
            return;
        }
        cb0 = allocated;
    }
    unsigned char *cr0 = cb0 + width;
    unsigned char *cb1 = cr0 + width;
    unsigned char *cr1 = cb1 + width;

    for (long cy = start; cy < end; cy++) {
        int row0 = (int)cy * 2;
        int row1 = row0 + 1;
        const unsigned char *rgb0 = job->image->pixels + (long)row0 * width * 3;
        rgb_to_ycbcr(rgb0, width, job->y->data + (long)row0 * width, cb0, cr0);
        if (row1 < height) {
            const unsigned char *rgb1 = job->image->pixels + (long)row1 * width * 3;
            rgb_to_ycbcr(rgb1, width, job->y->data + (long)row1 * width, cb1, cr1);
        } else {
            memcpy(cb1, cb0, (size_t)width);
            memcpy(cr1, cr0, (size_t)width);
        }

        unsigned char *out_cb = job->cb->data + cy * job->cb->width;
        unsigned char *out_cr = job->cr->data + cy * job->cr->width;
#if defined(__x86_64__) || defined(__i386__)
        if (job->use_avx2) {
            downsample_420_rows_avx2(cb0, cb1, cr0, cr1, width,
                                     out_cb, out_cr, job->cb->width);
            continue;
        }
#endif
        for (int x = 0; x < job->cb->width; x++) {
            int source = x * 2;
            int next = source + 1 < width ? source + 1 : width - 1;
            out_cb[x] = (unsigned char)((cb0[source] + cb0[next] +
                                         cb1[source] + cb1[next] + 2) >> 2);
            out_cr[x] = (unsigned char)((cr0[source] + cr0[next] +
                                         cr1[source] + cr1[next] + 2) >> 2);
        }
    }
    free(allocated);
#undef COLOR_STACK_WIDTH
}
Repara naquele COLOR_STACK_WIDTH logo no começo. Para imagens de largura razoável, os buffers temporários ficam na pilha, evitando uma alocação por chamada. Só imagens muito largas caem no malloc.
É um cuidado pequeno que importa quando a função roda milhares de vezes, e ele também deixa cada trabalhador com o seu próprio espaço, sem disputa nenhuma entre threads. 🧵
Afiada 6: escrita de símbolos em lote, em encoder.c
A sexta afiada volta ao escritor de bits do artigo 20.
Lá a gente trocou a escrita bit a bit por um acumulador de 64 bits, o que já foi um ganho grande. Acontece que cada símbolo ainda chama a função de escrita separadamente, e cada chamada verifica se é hora de descarregar bytes na memória.
Como os códigos de Huffman são curtos, dá para juntar vários símbolos no acumulador antes de qualquer verificação:
static inline void ac_batch_put(BitWriter *writer, AcBitBatch *batch,
                                unsigned int value, int count) {
    if (batch->count > 0 && batch->count + count > 32)
        ac_batch_flush(writer, batch);

    if (batch->count == 0) {
        batch->bits = value;
        batch->count = count;
    } else {
        batch->bits = (batch->bits << count) | value;
        batch->count += count;
    }
}
static inline void ac_batch_flush(BitWriter *writer, AcBitBatch *batch) {
if (batch->count > 0) {
bw_write_bits(writer, batch->bits, batch->count);
batch->bits = 0;
batch->count = 0;
}
}Com o lote no lugar, os dois casos de bloco ganham caminhos próprios. Blocos esparsos, onde poucos coeficientes sobreviveram, usam a máscara de não-zeros para pular direto de um ao outro:
static inline void write_ac_sparse(BitWriter *writer, const short *zz,
                                   unsigned long long mask,
                                   const HuffTable *ac_table) {
    int previous = 0;
    while (mask) {
        int position = __builtin_ctzll(mask);
        int run = position - previous - 1;
        while (run > 15) {
            bw_write_bits(writer, ac_table->code[0xF0], ac_table->len[0xF0]);
            run -= 16;
        }
        int value = zz[position];
        int coefficient_size = category(value);
        int symbol = (run << 4) | coefficient_size;
        bw_write_bits(writer,
                      (ac_table->code[symbol] << coefficient_size)
                          | amplitude(value, coefficient_size),
                      (int) ac_table->len[symbol] + coefficient_size);
        previous = position;
        mask &= mask - 1;
    }
    if (previous < 63)
        bw_write_bits(writer, ac_table->code[0x00], ac_table->len[0x00]);
}
Já os blocos densos produzem símbolos suficientes para compensar um lote: eles percorrem a mesma máscara, mas juntam vários códigos e amplitudes em uma palavra antes de chamar o escritor.
static inline void write_ac_dense(BitWriter *writer, const short *zz,
                                  unsigned long long mask,
                                  const HuffTable *ac_table) {
    AcBitBatch batch = {0, 0};
    int previous = 0;
    while (mask) {
        int position = __builtin_ctzll(mask);
        int run = position - previous - 1;
        while (run > 15) {
            ac_batch_put(writer, &batch,
                         ac_table->code[0xF0], ac_table->len[0xF0]);
            run -= 16;
        }
        int value = zz[position];
        int coefficient_size = category(value);
        int symbol = (run << 4) | coefficient_size;
        ac_batch_put(writer, &batch,
                     (ac_table->code[symbol] << coefficient_size)
                         | amplitude(value, coefficient_size),
                     (int) ac_table->len[symbol] + coefficient_size);
        previous = position;
        mask &= mask - 1;
    }
    if (previous < 63)
        ac_batch_put(writer, &batch,
                     ac_table->code[0x00], ac_table->len[0x00]);
    ac_batch_flush(writer, &batch);
}
Por que dois caminhos em vez de um só? Em blocos esparsos, mandar cada sobrevivente direto custa menos que manter um lote. A partir de oito ACs vivos, combinar os tokens reduz chamadas e passa a vencer. O limiar fica explícito em N148_DENSE_AC_THRESHOLD.
Os dois caminhos emitem exatamente a mesma sequência de bits. A escolha existe apenas para reduzir trabalho interno, e o cache guarda a contagem para que essa decisão não exija um novo popcount na escrita. 🔀
Afiada 7: o lookup passa a devolver uma ação inteira, em decoder.c
O lookup do artigo 21 já evitava caminhar bit a bit pelos códigos curtos, mas ainda devolvia apenas o símbolo. Depois dele, o decoder precisava ler a amplitude, restaurar o sinal, separar a corrida e testar EOB ou ZRL em etapas distintas.
A tabela final usa os mesmos dez bits de janela para guardar uma ação. Quando código e amplitude cabem juntos nesses dez bits, uma consulta já entrega o valor assinado, quantos bits consumir, a corrida e os casos especiais:
typedef struct {
    int min_code[17];
    int max_code[17];
    int value_index[17];
    const unsigned char *values;
    unsigned int action[1 << LOOKUP_BITS];
} HuffDecoder;

#define ACTION_BITS_SHIFT 16
#define ACTION_RUN_SHIFT  21
#define ACTION_EOB        (1u << 25)
#define ACTION_ZRL        (1u << 26)
#define ACTION_PARTIAL    (1u << 31)
Uma entrada resolvida ocupa os bits baixos com o valor já sinalizado. Os campos altos dizem quantos bits pular e, no AC, quantos zeros vieram antes. Se a amplitude não cabe na janela, ACTION_PARTIAL ainda guarda comprimento e símbolo; só códigos realmente longos caem no caminho canônico.
int symbol = spec->values[k];
int amplitude_size = is_ac ? (symbol & 0x0F) : symbol;
int special = is_ac && (symbol == 0x00 || symbol == 0xF0);
int total = length + (special ? 0 : amplitude_size);
if (total > LOOKUP_BITS || (!special && amplitude_size == 0))
    continue;

int amplitudes = special ? 1 : (1 << amplitude_size);
int suffix_bits = LOOKUP_BITS - total;
for (int amplitude = 0; amplitude < amplitudes; amplitude++) {
    int value = amplitude;
    if (!special && amplitude < (1 << (amplitude_size - 1)))
        value += 1 - (1 << amplitude_size);

    unsigned int action = (unsigned short)value;
    action |= (unsigned int)total << ACTION_BITS_SHIFT;
    if (is_ac) {
        action |= (unsigned int)(symbol >> 4) << ACTION_RUN_SHIFT;
        if (symbol == 0x00) action |= ACTION_EOB;
        if (symbol == 0xF0) action |= ACTION_ZRL;
    }

    int prefix = ((code << (special ? 0 : amplitude_size)) |
                  amplitude) << suffix_bits;
    int repeat = 1 << suffix_bits;
    for (int slot = prefix; slot < prefix + repeat; slot++)
        decoder->action[slot] = action;
}
No laço quente, o caso comum virou consulta, avanço e uso do valor. A lógica maior continua existindo para a entrada parcial e para códigos acima de dez bits, portanto nenhuma tabela Huffman válida perdeu suporte.
br_refill(reader);
unsigned int action = ac_decoder->action[br_peek(reader, LOOKUP_BITS)];
if (action && !(action & ACTION_PARTIAL)) {
    br_skip(reader, (action >> ACTION_BITS_SHIFT) & 31);
    if (action & ACTION_EOB) break;
    if (action & ACTION_ZRL) {
        position += 16;
        continue;
    }
    position += (action >> ACTION_RUN_SHIFT) & 15;
    value = (short)action;
} else {
    /* entrada parcial ou código longo: caminho canônico completo */
}
O leitor de bits também deixou de fazer uma carga sobreposta de 64 bits antes de cada símbolo. Como código Huffman mais amplitude ocupam no máximo 31 bits, manter 32 disponíveis é suficiente e simplifica o refill:
static inline void br_refill(BitReader *reader) {
    if (reader->available >= 32) return;

    if (reader->position + 4 <= reader->size) {
        unsigned int next = load_be32(reader->buffer + reader->position);
        reader->accumulator |=
            (unsigned long long)next << (32 - reader->available);
        reader->position += 4;
        reader->available += 32;
        return;
    }

    while (reader->available < 32) {
        unsigned long long byte = 0;
        if (reader->position < reader->size)
            byte = reader->buffer[reader->position++];
        else
            reader->padding += 8;
        reader->accumulator |= byte << (56 - reader->available);
        reader->available += 8;
    }
}
Essa é a peça que faltava para explicar a queda de tempo em entropia e IDCT. O primeiro lookup era correto, mas não era o lookup completo usado no resultado final.
Afiada 8: tocar somente no que sobreviveu, em decoder.c e dct.c
O decoder antigo zerava um vetor inteiro de inteiros, reconstruía os 64 lugares em zig-zag e depois passava pelos 64 de novo para dequantizar. Só que um bloco comprimido costuma ter poucos coeficientes vivos.
Agora cada amplitude é dequantizada no instante em que chega e escrita diretamente em ordem natural. O memset só acontece quando aparece o primeiro AC; um bloco DC puro nunca limpa o vetor de 64 floats:
int index = ZIGZAG[position];
if (nonzero_ac == 0) {
    memset(coefficients, 0, 64 * sizeof(*coefficients));
    coefficients[0] = dc_coefficient;
    single_ac_index = index;
} else if (nonzero_ac == 1) {
    second_ac_index = index;
} else if (nonzero_ac == 2) {
    third_ac_index = index;
}
coefficients[index] = value * dequant->multiplier[index];
nonzero_ac++;
Se nenhum AC apareceu, o retorno já carrega o byte final. Em blocos interiores, oito cópias de 64 bits pintam as oito linhas; nas bordas, memset respeita a largura real:
if (flat > 0) {
    unsigned char *dst = block_dst;
    if (max_x == 8) {
        unsigned long long packed = 0x0101010101010101ull *
                                    (unsigned int)(flat - 1);
        for (int r = 0; r < max_y; r++, dst += plane->width)
            memcpy(dst, &packed, sizeof(packed));
    } else {
        for (int r = 0; r < max_y; r++, dst += plane->width)
            memset(dst, flat - 1, (size_t)max_x);
    }
    continue;
}
Os atalhos de um a três ACs já escrevem direto no plano. A mesma ideia faltava para o caso denso: em vez de gerar 64 floats, voltar ao chamador e copiá-los um por um, a IDCT AVX2 compartilha seus oito vetores finais com uma rotina que arredonda, satura e grava cada linha.
__attribute__((target("avx2")))
void idct_block_store_avx2(const float coef[64],
                           unsigned char *dst, int stride) {
    __m256 r0,r1,r2,r3,r4,r5,r6,r7;
    idct_vectors_avx2(coef, &r0, &r1, &r2, &r3,
                      &r4, &r5, &r6, &r7);

    const __m256 shift = _mm256_set1_ps(128.0f);
    const __m256 round = _mm256_set1_ps(0.5f);
    store_idct_row_avx2(r0, dst + (long)stride * 0, shift, round);
    /* ...as outras sete linhas... */
    store_idct_row_avx2(r7, dst + (long)stride * 7, shift, round);
}
if (max_x == 8 && max_y == 8 && use_avx2) {
idct_block_store_avx2(block, block_dst, plane->width);
continue;
}Blocos parciais continuam usando o caminho que gera floats, porque a escrita precisa descartar o padding externo. A transformação de referência em double também permanece em dct.c para validação; o caminho quente usa as entradas AVX2 diretas depois que o chamador já decidiu o nível da CPU.
Afiada 9: máscara SIMD e cache contíguo, em encoder.c
O encoder precisa saber quais coeficientes quantizados não são zero. Fazer 64 testes escalares por bloco é exatamente o tipo de trabalho repetitivo que SIMD resolve bem. Quatro comparações AVX2 cobrem os 64 shorts e movemask entrega os bits:
__attribute__((target("avx2")))
static unsigned long long nonzero_mask_avx2(const short *zz) {
    unsigned long long mask = 0;
    const __m256i zero = _mm256_setzero_si256();
    for (int group = 0; group < 4; group++) {
        __m256i values = _mm256_loadu_si256(
            (const __m256i *)(zz + group * 16));
        __m256i is_zero = _mm256_cmpeq_epi16(values, zero);
        __m128i packed = _mm_packs_epi16(
            _mm256_castsi256_si128(is_zero),
            _mm256_extracti128_si256(is_zero, 1));
        unsigned int bits = (unsigned int)_mm_movemask_epi8(packed);
        mask |= ((unsigned long long)((~bits) & 0xFFFFu)) << (group * 16);
    }
    return mask;
}
Coeficientes, máscaras e contagens pertencem à mesma vida útil, então pedir uma alocação para cada vetor só aumentaria metadados e espalharia os dados. A versão final pede um bloco contíguo e calcula os dois ponteiros internos:
typedef struct {
    short *coefficients;
    unsigned long long *nonzero_masks;
    unsigned char *nonzero_counts;
    long count;
} CoeffCache;

size_t coefficient_bytes = (size_t)total * 64 * sizeof(short);
size_t mask_bytes = (size_t)total * sizeof(*cache->nonzero_masks);
size_t count_bytes = collect ? (size_t)total : 0;
cache->coefficients = (short *)malloc(
    coefficient_bytes + mask_bytes + count_bytes);
cache->nonzero_masks = (unsigned long long *)
    ((unsigned char *)cache->coefficients + coefficient_bytes);
cache->nonzero_counts = collect
    ? (unsigned char *)cache->nonzero_masks + mask_bytes : NULL;
A contagem de ACs é produzida junto das frequências, enquanto o bloco ainda está quente, e fica guardada para a escolha entre escrita esparsa e densa. Assim a segunda passada não faz outro popcount.
Existe ainda uma microdecisão importante: o nível SIMD é calculado uma vez na montagem do trabalho. Dentro de cada bloco, quem já sabe que está no caminho AVX2 chama a entrada AVX2 diretamente, sem repetir CPUID, override e branch:
#if defined(__x86_64__) || defined(__i386__)
if (job->use_avx2) dct_block_avx2(block, coef);
else
#endif
dct_block_fast(block, coef);

#if defined(__x86_64__) || defined(__i386__)
if (job->use_avx2)
    quantize_avx2(coef, job->quant->recip, ZIGZAG, out);
else
#endif
quantize_scalar(coef, job->quant->recip, ZIGZAG, out);
Afiada 10: reservar fora do escritor quente, em encoder.c
O acumulador de bits ficou rápido, mas ainda verificava capacidade em cada chamada. A saída não precisa crescer símbolo por símbolo: basta garantir uma margem antes de começar o bloco.
static int bw_reserve(BitWriter *writer, long extra) {
    if (writer->size + extra <= writer->capacity) return 1;
    long wanted = writer->capacity * 2;
    while (wanted < writer->size + extra) wanted *= 2;
    unsigned char *grown = (unsigned char *)realloc(writer->buffer, wanted);
    if (!grown) return 0;
    writer->buffer = grown;
    writer->capacity = wanted;
    return 1;
}
O buffer começa com uma estimativa proporcional à quantidade de blocos. Antes de cada bloco, 288 bytes cobrem com folga o pior caso de 64 códigos e amplitudes; depois disso bw_write_bits pode ficar sem teste de capacidade no laço interno:
long guess = (cache_y.count + cache_cb.count + cache_cr.count) * 24 + 4096;
bw_init(&writer, guess);

const long block_margin = 288;
for (long b = 0; b < cache->count; b++) {
    if (writer->size + block_margin > writer->capacity) {
        if (!bw_reserve(writer, block_margin)) return b;
    }
    /* escreve DC e AC sem testar capacidade em cada símbolo */
}
A margem não altera um único bit do formato. Ela apenas desloca uma condição que rodava dezenas de vezes por bloco para um ponto que roda uma vez.
Afiada 11: as últimas viagens e multiplicações, em ppm.c e decoder.c
Na conversão RGB→YCbCr, as três linhas de coeficientes têm uma propriedade útil: os pesos de Y somam um e os pesos de cada croma somam zero. Tirar o azul como base elimina uma multiplicação de 32 bits por canal sem mudar a aritmética inteira:
__m256i rb = _mm256_sub_epi32(r, b);
__m256i gb = _mm256_sub_epi32(g, b);

__m256i luma = _mm256_add_epi32(
    _mm256_add_epi32(_mm256_mullo_epi32(rb, yr),
                     _mm256_mullo_epi32(gb, yg)),
    _mm256_add_epi32(_mm256_slli_epi32(b, YCC_FIX_BITS), half));
__m256i blue_diff = _mm256_add_epi32(
    _mm256_add_epi32(_mm256_mullo_epi32(rb, cbr),
                     _mm256_mullo_epi32(gb, cbg)), offset);
__m256i red_diff = _mm256_add_epi32(
    _mm256_add_epi32(_mm256_mullo_epi32(rb, crr),
                     _mm256_mullo_epi32(gb, crg)), offset);
A DCT escalar também passou a usar a mesma ordem de passadas da AVX2. As duas ordens são matematicamente equivalentes, mas alinhá-las evita que os últimos bits de um float atravessem uma fronteira de quantização em qualidade alta. Isso é o que permite exigir bytes iguais entre os níveis.
Por fim, paralelizar não é obrigação. O merge de uma imagem pequena dura poucos décimos de milissegundo; até um pool persistente pode custar mais que isso. A decisão final usa o tamanho da imagem como corte:
/* Small images finish faster without the pool handover. */
if ((long)width * height < 512L * 1024L)
    merge_rows(0, height, 0, &job);
else
    n148_parallel_for(height, merge_rows, &job);
É um fechamento importante para o tema deste artigo: usar todos os núcleos é uma ferramenta, não um mandamento. Primeiro se mede o tamanho do trabalho; só depois se decide dividir. 🧠
Recapitulando as afiadas
São onze mudanças, todas aplicando ideias que já apareceram antes na série:
- IDCT esparsa em
dct.c: um, dois ou três ACs são reconstruídos a partir de bases pré-calculadas. - Descritor esparso em
decoder.c: DC puro, transformada completa e casos esparsos têm retornos distintos. - Upsampling AVX2 em
decoder.c: mistura vertical e esticamento horizontal trabalham em vetores. - Conversão FMA em
decoder.c: o nível AVX2+FMA acelera os canais que preservam a mesma ordem de arredondamento. - 4:2:0 fundido em
ppm.c: conversão e redução acontecem na mesma passada. - AC em lote em
encoder.c: o limiar de oito sobreviventes seleciona escrita direta ou agrupada. - Ações Huffman em
decoder.c: o lookup resolve símbolo e amplitude juntos, com refill de 32 bits. - Dequantização e IDCT diretas em
decoder.c: apenas valores vivos são tocados e blocos interiores vão direto ao plano. - Máscara e cache contíguo em
encoder.c: AVX2 encontra não-zeros e a contagem fica guardada ao lado dos coeficientes. - Reserva e dispatch fora do laço em
encoder.c: capacidade e nível da CPU são decididos uma vez por faixa ou bloco. - Caminho de dados final em
ppm.cedecoder.c: multiplicações redundantes somem e imagens pequenas evitam o handover paralelo.
Com todas elas no lugar, o codec finalmente corresponde à implementação otimizada que será usada nas medições. Antes de olhar tempos, falta provar que os atalhos não mudaram o formato nem os pixels. 📏
Antes de medir: provar que continua igual
Otimização só termina depois da prova de equivalência. Rodar uma imagem e olhar para ela não basta: os bugs mais chatos aparecem numa borda incompleta, num modo de croma menos usado ou numa diferença de arredondamento que muda um símbolo.
Por isso o repositório agora traz um Makefile, um driver de benchmark e um validador. O validador executa o mesmo ciclo em nível escalar e AVX2, depois repete uma imagem 317×241 nos três modos de croma com um e quatro trabalhadores.
- o arquivo N.148i precisa ser idêntico byte a byte entre os caminhos de CPU;
- os pixels reconstruídos e o PSNR também precisam ser idênticos;
- um e quatro trabalhadores precisam produzir o mesmo arquivo e a mesma imagem;
- o decoder precisa consumir exatamente o tamanho do payload;
- dimensões ímpares e blocos parciais precisam voltar com a dimensão original.
make
make bench
make validate
./validate

# Também existe uma compilação completamente sem threads:
make clean
make NOTHREADS=1 validate
Na imagem oficial de 320×240 e qualidade 50, o teste escalar e o AVX2 chegam aos mesmos números:
cycle,example_scalar,scalar,1,2,320,240,2290,2145,2145,34.696364629236
cycle,example_avx2,AVX2,1,2,320,240,2290,2145,2145,34.696364629236
comparison,scalar_vs_avx2,...,byte_and_psnr_identical,PASS

odd_chroma0_t1_vs_t4  PASS
odd_chroma1_t1_vs_t4  PASS
odd_chroma2_t1_vs_t4  PASS
O executável principal também aceita caminho, qualidade e croma na linha de comando, sem exigir uma recompilação para cada ponto. O bench recebe ainda repetições e quantidade de trabalhadores; o driver de comparação com JPEG fica preparado para o próximo artigo.
./n148i images/example.ppm 50 2
./bench images/example.ppm 50 100 2 1
./bench images/example.ppm 50 100 2 4
Só depois de todos esses testes passarem os tempos abaixo entram na conversa. Assim, velocidade não ganha o direito de esconder uma mudança de formato ou de qualidade. ✅
Os resultados, num núcleo só
Vamos começar pelo cenário sem paralelismo, para separar o que veio de cada coisa:
Imagem    │ Encode 23 │ Encode 24 │  Ganho  │ Decode 23 │ Decode 24 │  Ganho
──────────┼───────────┼───────────┼─────────┼───────────┼───────────┼─────────
portrait  │  2,98 ms  │  1,36 ms  │  2,19x  │  7,08 ms  │  0,70 ms  │ 10,11x
smooth    │  8,20 ms  │  3,42 ms  │  2,40x  │ 19,73 ms  │  1,61 ms  │ 12,25x
O decode ficou dez vezes mais rápido. 🤯
E isso ainda é com um núcleo, ou seja, nada disso veio de paralelismo. Veio das afiadas listadas acima.
Olhando o perfil, dá para ver de onde:
DECODE (portrait)         │ Artigo 23 │ Artigo 24
──────────────────────────┼───────────┼───────────
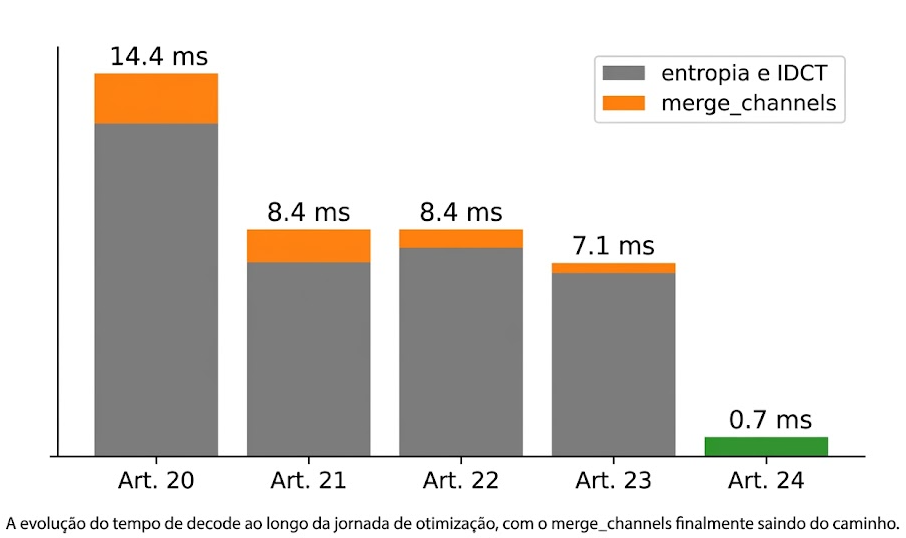
Entropia e IDCT           │  2,22 ms  │  0,51 ms
merge_channels            │  5,11 ms  │  0,28 ms
O merge_channels, que foi o vilão de três artigos seguidos, caiu de 5,11 ms para 0,28 ms. Dezoito vezes menor.
A combinação de upsampling vetorizado com a conversão de cor usando FMA finalmente resolveu aquele gargalo que a gente vinha empurrando desde o artigo 21. 🎉
Agora sim: o paralelismo
Agora dá uma olhada nesses números:
Threads │  Encode   │  Decode   │ Speedup enc │ Speedup dec
────────┼───────────┼───────────┼─────────────┼─────────────
   1    │ 1884,5 ms │  977,8 ms │    1,00x    │    1,00x
   2    │ 1414,7 ms │  838,5 ms │    1,33x    │    1,17x
   4    │ 1682,7 ms │  984,3 ms │    1,12x    │    0,99x
   8    │ 1271,3 ms │  842,0 ms │    1,48x    │    1,16x
  10    │ 1195,3 ms │  814,8 ms │    1,58x    │    1,20x
(Os tempos são a soma de cem imagens, por isso os números grandes.)
Duas coisas saltam aos olhos nessa tabela, e as duas merecem explicação.
Primeira surpresa: dez núcleos não dão dez vezes
Com dez threads, o encode ficou 1,58x mais rápido. Não dez vezes, nem cinco, apenas um pouco mais que uma vez e meia.
Frustrante? Não, esperado. E a culpa é daquela divisão que a gente fez lá no começo do artigo.
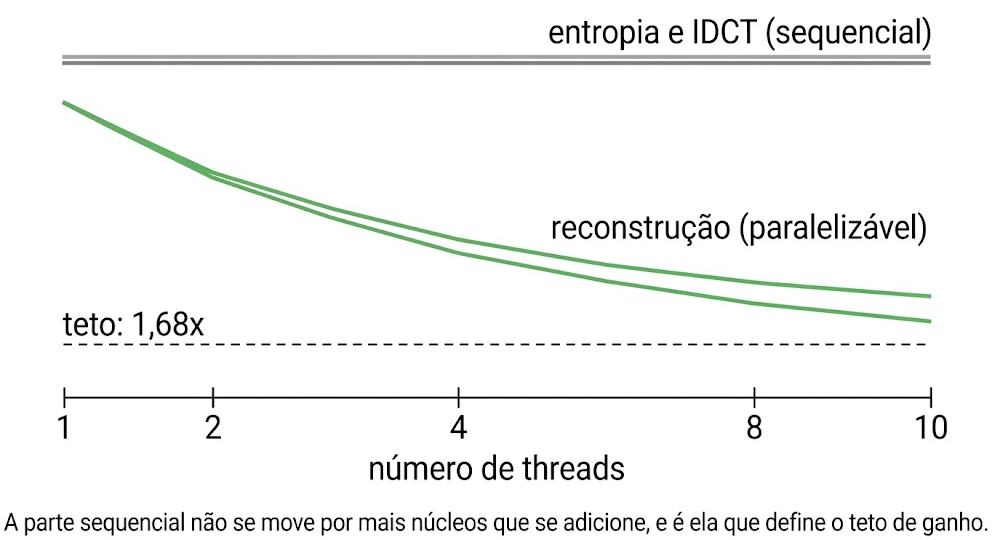
Lembra que a escrita dos bits e a cadeia do DC não podem ser divididas? Elas continuam rodando num núcleo só, por mais núcleos que você adicione.
Existe uma fórmula que descreve exatamente isso, e ela se chama Lei de Amdahl. Se uma fração do programa é sequencial, ela vira um piso que nenhuma quantidade de núcleos consegue furar.
Fazendo a conta ao contrário, com um speedup de 1,58x usando dez núcleos, dá para deduzir que cerca de 41% do encode é paralelizável. E daí sai o teto:
fração paralelizável:  41%
speedup com 10 núcleos: 1,58x
teto com infinitos núcleos: 1,68x
Ou seja, mesmo com mil núcleos o encode não passaria de 1,68x. O restante é sequencial e ponto final. 🧱
No decode a situação é ainda mais clara, e o perfil por estágio mostra isso de forma quase didática:
Threads │  planes (entropia+IDCT) │  merge (reconstrução)
────────┼─────────────────────────┼──────────────────────
   1    │        557,4 ms         │       418,9 ms
   2    │        560,2 ms         │       276,1 ms
   8    │        563,7 ms         │       275,2 ms
  10    │        567,0 ms         │       244,4 ms
Olha a coluna do planes: ela fica parada, de 557 a 567 ms, não importa quantas threads você jogue. É a parte sequencial, e ela não se mexe.
Já a coluna do merge cai de 419 para 244 ms, porque a reconstrução é paralelizável.
É a Lei de Amdahl escrita em duas colunas de uma tabela. 📊
Segunda surpresa: quatro núcleos ficaram mais lentos que dois
Volte na tabela de escalonamento e olhe a linha de quatro threads. O encode foi de 1414 ms com duas threads para 1682 ms com quatro.
Adicionar núcleos deixou o programa mais lento. Isso não deveria acontecer, então fui investigar. 🕵️
A resposta estava na coluna que eu quase ignorei, a que lista quais núcleos foram usados:
Threads │ núcleos usados
────────┼──────────────────────────
   2    │ 0,2
   4    │ 0,2,4,5
   8    │ 0,2,4,5,6,7,8,9
O processador daquela máquina é híbrido. Ele tem dois núcleos de alto desempenho, que os fabricantes chamam de performance cores, e oito núcleos de eficiência, os efficiency cores, que são bem mais lentos.
Com duas threads, o teste usou os dois núcleos rápidos. Com quatro threads, entraram dois núcleos lentos na jogada.
E aqui está o problema: o nosso parallel_for divide o trabalho em partes iguais. Ele assume, sem dizer, que todos os trabalhadores têm a mesma capacidade.
com 2 threads (2 núcleos rápidos):
  cada um faz 50% do trabalho, em velocidade alta

com 4 threads (2 rápidos + 2 lentos):
  cada um faz 25% do trabalho
  os rápidos terminam cedo e FICAM ESPERANDO
  o tempo total é ditado pelo mais lento
A operação inteira só termina quando o último trabalhador termina. Se um deles é bem mais devagar e recebeu a mesma carga que os outros, todo mundo espera por ele. 🐌
A correção seria distribuir de forma proporcional à capacidade de cada núcleo, dando fatias menores aos mais lentos. Só que isso exige descobrir a topologia do processador e medir a capacidade relativa, o que é bem mais complexo do que parece.
Fica registrado como uma limitação conhecida, e como um lembrete de que uma suposição silenciosa (a de que todos os núcleos são iguais) pode ficar escondida no código por muito tempo até uma máquina específica revelar ela.
💡 A lição: em processadores híbridos, dividir o trabalho igualmente não é dividir de forma justa. E vale o alerta geral: quando um resultado contraria a expectativa, quase sempre existe uma suposição errada em algum lugar, e vale a pena caçar ela em vez de aceitar o número.
Sobre comparar com um programa que não paraleliza
Tem um cuidado metodológico que eu quero deixar registrado, porque ele vai importar bastante no próximo artigo.
Quando a gente compara o nosso codec rodando com dez threads contra outro que usa uma só, a comparação não é injusta, mas ela responde uma pergunta diferente.
- Mesma quantidade de CPU: o nosso codec com uma thread contra o outro com uma thread. Isso mede eficiência.
- Mesma máquina, tempo de parede: o nosso com todas as threads contra o outro com uma. Isso mede throughput, que é o que o usuário sente.
As duas perguntas são legítimas, e a resposta de uma não vale como resposta da outra. Misturar as duas num número só é o tipo de coisa que faz um benchmark parecer melhor do que é.
Quando chegarmos no julgamento, eu vou reportar os dois eixos separadamente. 🫡
Onde o codec chegou
Fechando a jornada de otimização, vale olhar de onde a gente saiu e onde chegou. Todos os números abaixo são de um núcleo só, na mesma máquina e na mesma imagem:
Artigo │ O que entrou                        │ Encode   │ Decode
───────┼─────────────────────────────────────┼──────────┼──────────
  18   │ (ponto de partida, sem -O2)         │ 68,76 ms │ 47,93 ms
  19   │ flag -O2 e DCT rápida AAN           │  9,86 ms │ 15,81 ms
  20   │ cache de coeficientes, bit writer   │  6,25 ms │ 15,43 ms
  21   │ lookup Huffman, upsampling inteiro  │  6,08 ms │  8,36 ms
  22   │ SIMD na DCT                         │  5,80 ms │  8,47 ms
  23   │ SIMD na conversão de cor            │  3,06 ms │  7,18 ms
  24   │ afiadas finais e paralelismo        │  1,36 ms │  0,70 ms
Do começo ao fim: o encode ficou 50 vezes mais rápido e o decode 68 vezes mais rápido. 🚀
E o mais importante de tudo, aquilo que a gente verificou em cada um dos seis artigos: a saída continua correta. Os arquivos gerados abrem igual, a qualidade não mudou, e o caminho escalar produz exatamente os mesmos bytes que o caminho vetorial.
=== escalar vs AVX2 ===
portrait:
  nivel 0: 26540 bytes  PSNR 32.0617 dB
  nivel 2: 26540 bytes  PSNR 32.0617 dB
O que aprendemos nesta jornada
Seis artigos depois, se eu tivesse que resumir o que essa empreitada me ensinou, seriam três coisas.
A primeira é que medir vem antes de tudo. Em cada artigo o gargalo estava num lugar diferente, e em quase todos ele não estava onde a intuição apontava: a DCT era a vilã no artigo 19 e virou 3% do tempo no artigo 22, enquanto o merge_channels, que parecia mero acabamento, dominou o decode por três artigos seguidos.
A segunda é que otimização boa não troca qualidade por velocidade. Toda vez que o resultado mudou, isso foi investigado e relatado, e na maioria das vezes era um sinal de erro, como naquele arredondamento prematuro que custou 0,15 dB no artigo 21.
A terceira é que os resultados surpreendentes são os mais valiosos. A amostragem que quebrou o codec, o gather que ganhou no teste e empatou na prática, os quatro núcleos mais lentos que dois. Cada um desses ensinou mais do que uma otimização que simplesmente funcionou.
Repositório no GitHub
E sim, você pode acompanhar a evolução desse CODEC de imagens em um repositório no GitHub, commit por commit 👋
Segue o link abaixo do commit desse artigo, onde implementamos o paralelismo e as otimizações finais:
Resumo
Recapitulando:
- Paralelismo só entra onde as fatias são independentes; o fluxo de bits e a cadeia diferencial do DC continuam sequenciais.
- O
parallel_forusa um pool persistente, reaproveita até 31 threads de fundo e deixa a thread chamadora executar a fatia zero. n148_set_thread_countpermite medir o mesmo binário com quantidades diferentes de trabalhadores;N148_NO_THREADSmantém o fallback portátil.- Contadores Huffman usam redução: cada trabalhador escreve em seus próprios 256 contadores e a soma acontece no fim.
- O decoder funde Huffman, amplitude, sinal e corrida em uma ação, dequantiza só os coeficientes vivos e grava blocos DC, esparsos e densos diretamente no plano quando possível.
- O encoder usa máscara de não-zeros AVX2, cache contíguo com contagem de AC, dispatch direto da DCT e reserva de capacidade uma vez por bloco.
- Upsampling AVX2, FMA, 4:2:0 fundido e a álgebra fatorada da conversão de cor reduzem contas e tráfego de memória sem mudar o arquivo.
- Trabalhos curtos e o merge de imagens com menos de 512×1024 pixels rodam inline para não pagar mais sincronização do que trabalho.
- Com dez núcleos, o encode medido ficou 1,58x mais rápido; a parte sequencial limita o teto pela Lei de Amdahl.
- Num processador híbrido, quatro trabalhadores podem perder para dois quando fatias iguais caem em núcleos de capacidades diferentes.
- A validação compara bytes, pixels, consumo do payload, caminhos scalar/AVX2 e um/quatro trabalhadores antes de aceitar qualquer ganho.
- Resultado da jornada inteira: encode 50x e decode 68x mais rápidos no ambiente medido, preservando bitstream, dimensões e qualidade.
E é aqui que a nossa empreitada de otimização termina. O N.148i comprime bem e agora roda rápido, e cada linha desse caminho foi medida, verificada e explicada.
No próximo artigo chega enfim o dia do julgamento. ⚖️
Vamos colocar o N.148i frente a frente com o JPEG e com o JPEG XL, medindo tamanho, velocidade de compressão e velocidade de descompressão, num conjunto grande de imagens para que o resultado signifique alguma coisa.
E vai ser um benchmark feito com rigor, comparando na mesma qualidade reconstruída em vez de na mesma configuração, separando os eixos de eficiência e throughput, e reportando também onde a gente perde.
Foi para isso que a gente passou seis artigos afiando o codec. Agora dá para julgar de igual para igual. 🥊
Prepara o café ☕, porque o próximo é o dia da verdade.
Até lá! 👋