
SIMD na prática: cor, quantização e três armadilhas
Olá leitor, seja muito bem vindo de volta a mais uma etapa da nossa jornada aqui no Portal da Micilini! 😊
Este é o vigésimo terceiro artigo da nossa série, e o quinto da nossa empreitada de otimização.
No artigo passado a gente construiu toda a fundação do SIMD: aprendeu o que são as instruções vetoriais, descobriu que os intrinsics resolvem sem precisar escrever assembly, montou a detecção de processador em tempo de execução e aplicou tudo isso na DCT.
O resultado da transformada foi ótimo, ficando quase quatro vezes mais rápida. Só que o codec inteiro melhorou apenas 5%, porque a DCT já não era o gargalo.
Hoje a gente pega a mesma ferramenta e aponta ela para onde o tempo realmente está.
E além do ganho, que dessa vez é grande, tem três armadilhas para contar. Uma delas me pegou de um jeito que ainda acho engraçado: uma instrução criada exatamente para o problema que eu tinha, que parecia perfeita no papel, e que num teste me disse uma coisa e no código real me disse outra. 🪤
Sendo assim, pega o café e vamos nessa! ☕
Olhando onde o tempo está
Retomando de onde paramos, o perfil do codec no fim do artigo 22 estava assim:
ENCODE                    │ portrait │ smooth
──────────────────────────┼──────────┼──────────
Conversão de cor          │  2,43 ms │  7,69 ms
Resto do encode           │  3,42 ms │  9,06 ms

DECODE                    │ portrait │ smooth
──────────────────────────┼──────────┼──────────
Entropia e IDCT           │  2,10 ms │  4,33 ms
merge_channels            │  6,10 ms │ 18,97 ms
Dois números saltam aos olhos. A conversão de cor come 42% do encode, e o merge_channels, que é onde vive a conversão inversa, responde por 74% do decode.
Ou seja: os dois maiores custos do codec são a mesma coisa, apenas em direções opostas. Converter RGB para YCbCr na entrada, e YCbCr para RGB na saída.
Mas por que justo isso é tão caro? A conta em si é simples, com três multiplicações e algumas somas por canal.
O problema é a escala. Numa imagem de 512x512 são 262 mil pixels, e cada um deles passa por nove multiplicações em ponto flutuante, três arredondamentos e três verificações de limite.
Nenhuma dessas operações é cara sozinha, porém multiplicadas por 262 mil elas viram o item mais pesado do codec inteiro.
Frente 1: RGB para YCbCr em oito pixels de cada vez
Vamos começar pelo lado do encoder. A conversão que a gente escreveu lá no artigo 15 foi escrita dessa forma:
    for (long i = 0; i < pixel_count; i++) {
        double red = image->pixels[i * 3 + 0];
        double green = image->pixels[i * 3 + 1];
        double blue = image->pixels[i * 3 + 2];

        y->data[i] = clamp_byte(
            0.299000 * red + 0.587000 * green + 0.114000 * blue);
        cb_full[i] = clamp_byte(
            -0.168736 * red - 0.331264 * green + 0.500000 * blue + 128.0);
        cr_full[i] = clamp_byte(
            0.500000 * red - 0.418688 * green - 0.081312 * blue + 128.0);
    }
Note que escrevemos um pixel por volta de laço. A ideia agora é processar oito de uma vez, e para isso precisamos resolver dois problemas.
Problema um: os pixels estão embaralhados
Repara em como os pixels ficam guardados na memória:
memória:  R G B  R G B  R G B  R G B  ...
          pixel0 pixel1 pixel2 pixel3
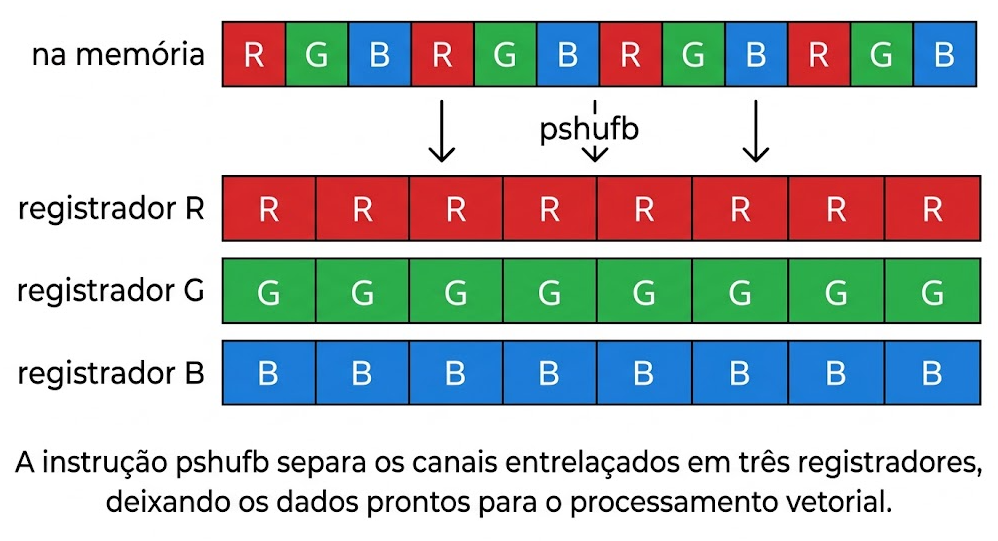
Os três canais vêm entrelaçados, um atrás do outro. Isso é ótimo para quem quer ler um pixel inteiro, mas péssimo para o SIMD.
Um registrador vetorial quer carregar oito valores consecutivos. Se a gente carregar oito bytes seguidos dessa memória, vai pegar dois pixels e um pedaço, com os canais todos misturados.
Sendo assim, para resolver esse tipo de coisa, o que a gente precisa é separar os canais:
queremos:   R R R R R R R R    (num registrador)
            G G G G G G G G    (noutro)
            B B B B B B B B    (noutro)
Existe uma instrução feita exatamente para esse tipo de reorganização, e ela se chama pshufb, de packed shuffle bytes.
O funcionamento dela é curioso. Você dá a ela um registrador com dados e outro registrador que funciona como um mapa, dizendo de onde cada byte de saída deve vir.
dados:  [ R0 G0 B0 R1 G1 B1 R2 G2 B2 R3 G3 B3 ... ]
mapa:   [  0 -1 -1 -1  3 -1 -1 -1  6 -1 -1 -1 ... ]
saída:  [ R0  0  0  0 R1  0  0  0 R2  0  0  0 ... ]
O mapa diz: pegue o byte da posição 0, depois nada, nada, nada, depois o byte da posição 3, e assim por diante. Lembrando que aqueles -1 significam zero.
Com três mapas diferentes, um para cada canal, a gente separa os três de uma vez só:
    const __m256i shuffle_r = _mm256_setr_epi8(
        0,-1,-1,-1, 3,-1,-1,-1, 6,-1,-1,-1, 9,-1,-1,-1,
        0,-1,-1,-1, 3,-1,-1,-1, 6,-1,-1,-1, 9,-1,-1,-1);
    const __m256i shuffle_g = _mm256_setr_epi8(
        1,-1,-1,-1, 4,-1,-1,-1, 7,-1,-1,-1,10,-1,-1,-1,
        1,-1,-1,-1, 4,-1,-1,-1, 7,-1,-1,-1,10,-1,-1,-1);
    const __m256i shuffle_b = _mm256_setr_epi8(
        2,-1,-1,-1, 5,-1,-1,-1, 8,-1,-1,-1,11,-1,-1,-1,
        2,-1,-1,-1, 5,-1,-1,-1, 8,-1,-1,-1,11,-1,-1,-1);
Repara que cada mapa aparece duplicado, e isso tem um motivo. O registrador de 256 bits é tratado internamente como duas metades independentes de 128 bits, e o embaralhamento acontece dentro de cada metade separadamente.
A gente aproveita isso carregando quatro pixels em cada metade, o que dá os oito pixels por volta:
        const unsigned char *p = rgb + i * 3;
        __m128i lo = _mm_loadu_si128((const __m128i *)(p));
        __m128i hi = _mm_loadu_si128((const __m128i *)(p + 12));
        __m256i packed = _mm256_set_m128i(hi, lo);

        __m256i r = _mm256_shuffle_epi8(packed, shuffle_r);
        __m256i g = _mm256_shuffle_epi8(packed, shuffle_g);
        __m256i b = _mm256_shuffle_epi8(packed, shuffle_b);
Problema dois: o ponto flutuante acaba atrapalhando aqui
Resolvido o embaralhamento, sobra a conta em si.
A versão original usa double, e isso funciona bem no código escalar. Só que no mundo vetorial existe um detalhe importante: um registrador de 256 bits guarda quatro valores double, mas guarda oito valores inteiros de 32 bits.
Ou seja, trabalhar com inteiros dobra quantos pixels cabem em cada instrução.
Mas como fazer contas com números quebrados usando só inteiros?
A resposta é uma técnica antiga e elegante chamada ponto fixo. A ideia é multiplicar todos os coeficientes por uma potência de dois, fazer as contas com inteiros grandes, e deslocar o resultado de volta no final.
Por exemplo, em vez de multiplicar por 0,299, a gente multiplica por 0,299 vezes 65536, que dá 19595. No fim, desloca 16 bits para a direita, que é o mesmo que dividir por 65536.
#define YCC_FIX_BITS 16
#define YCC_FIX(x)   ((int)((x) * (1 << YCC_FIX_BITS) + 0.5))
#define YCC_HALF     (1 << (YCC_FIX_BITS - 1))

static const int YCC_YR =  YCC_FIX(0.299000);
static const int YCC_YG =  YCC_FIX(0.587000);
static const int YCC_YB =  YCC_FIX(0.114000);
Aquele YCC_HALF é um detalhe fino que vale explicar. Somar metade do divisor antes de dividir transforma um truncamento em arredondamento, o que evita um viés sistemático para baixo.
É o mesmo truque que a gente usou no upsampling do artigo 21, com aquele + 8 antes de dividir por 16.
O clamp que sai de graça
Tem mais um detalhe bonito nessa conversão.
Depois da conta, cada valor precisa ser limitado à faixa de 0 a 255. Na versão escalar isso são duas comparações por canal, ou seja, seis por pixel.
Acontece que existe uma instrução que já faz isso como efeito colateral. Quando a gente empacota valores de 32 bits para 8 bits, existe uma variante que faz saturação sem sinal: qualquer coisa abaixo de zero vira zero, e qualquer coisa acima de 255 vira 255.
        // Packing with unsigned saturation performs the 0..255 clamp
        // for free, so no comparison is needed on the way out.
        __m128i y16 = _mm_packs_epi32(_mm256_castsi256_si128(luma),
                                      _mm256_extracti128_si256(luma, 1));

        _mm_storel_epi64((__m128i *)(y  + i), _mm_packus_epi16(y16, y16));
As seis comparações por pixel simplesmente desapareceram, porque a instrução que a gente já precisava usar de qualquer jeito já faz o trabalho. 🎁
O resultado da primeira frente
Imagem    │ Artigo 22 │ Com SIMD  │ Ganho
──────────┼───────────┼───────────┼───────
portrait  │  5,91 ms  │  4,47 ms  │ 1,32x
smooth    │ 15,80 ms  │ 12,16 ms  │ 1,30x
Trinta por cento no encode inteiro, vindo de uma única função. Bem diferente dos 5% do artigo passado. 🎉
Frente 2: tratando a volta, de YCbCr para RGB
No decoder o problema é o mesmo, só que ao contrário. A gente tem três canais separados e precisa produzir pixels entrelaçados.
A conta em si segue a mesma receita, com ponto fixo e saturação. A parte nova é a saída, porque agora precisamos montar o entrelaçamento em vez de desfazer.
A ferramenta é a mesma de antes, apenas com os mapas invertidos:
// Interleaves eight pixels worth of separate R, G and B bytes into
// the 24 packed bytes the output image expects.
    const __m128i mr0 = _mm_setr_epi8( 0,-1,-1, 1,-1,-1, 2,-1,-1, 3,-1,-1, 4,-1,-1, 5);
    const __m128i mg0 = _mm_setr_epi8(-1, 0,-1,-1, 1,-1,-1, 2,-1,-1, 3,-1,-1, 4,-1,-1);
    const __m128i mb0 = _mm_setr_epi8(-1,-1, 0,-1,-1, 1,-1,-1, 2,-1,-1, 3,-1,-1, 4,-1);

    _mm_storeu_si128((__m128i *) out,
        _mm_or_si128(_mm_or_si128(_mm_shuffle_epi8(r, mr0),
                                  _mm_shuffle_epi8(g, mg0)),
                     _mm_shuffle_epi8(b, mb0)));
Olha o que está acontecendo aí: cada canal é espalhado nas suas posições finais, deixando buracos onde os outros canais vão entrar, e depois um simples ou binário junta os três, já que os buracos são zeros e não atrapalham. 🧩
Um detalhe prático que quase me pegou: oito pixels ocupam 24 bytes, mas a instrução de gravação escreve 16 de cada vez.
Isso significa que o laço precisa parar um pouco antes do fim da linha e deixar os últimos pixels para o caminho escalar, senão a gente escreve além do buffer.
    int i = 0;
    // The interleaved store writes 24 bytes through a 16 byte store,
    // so the final group is finished by the scalar tail below.
    for (; i + 16 <= count; i += 8) {
        /* ...caminho vetorial... */
    }

    for (; i < count; i++) {
        /* ...caminho escalar para o resto... */
    }
Esse padrão de laço vetorial mais rabo escalar aparece o tempo todo em código SIMD. Praticamente nenhuma imagem tem largura múltipla de oito, então sempre sobra alguma coisa.
O resultado da segunda frente
Gostaria que você dê uma olhada atentamente nos resultados abaixo:
Imagem    │ Decode 22 │ Decode 23 │ Ganho
──────────┼───────────┼───────────┼───────
portrait  │  8,47 ms  │  7,18 ms  │ 1,18x
smooth    │ 23,31 ms  │ 20,19 ms  │ 1,15x
Note que ele está menor que o ganho do próprio encoder, e já explico o motivo mais adiante.
Frente 3: a armadilha do gather
Agora a história que eu prometi.
Sobrou um ponto do encoder que ainda não estava vetorizado: a quantização, aquele passo que divide cada coeficiente pela tabela e reordena o resultado em zig-zag.
    for (int i = 0; i < 64; i++) {
        int index = ZIGZAG[i];
        zigzag[i] = (short)lrintf(
            coefficients[index] * quantization->reciprocal[index]);
    }
Repara no coefficients[index]. Esse acesso é espalhado, porque o zig-zag pula pela matriz e as posições lidas não são consecutivas.
E acesso espalhado é justamente o que impede o SIMD, que quer sempre carregar valores vizinhos.
Só que existe uma instrução criada exatamente para esse problema. Ela se chama gather, e faz o seguinte: você dá a ela oito endereços, e ela busca os oito valores de uma vez, mesmo espalhados pela memória.
Perfeito, não é? Era como se a instrução tivesse sido inventada para o nosso caso. 🎯
    for (int i = 0; i < 64; i += 8) {
        __m256i index = _mm256_loadu_si256((const __m256i *)(zigzag + i));
        __m256 values = _mm256_i32gather_ps(coef, index, 4);
        __m256 scale  = _mm256_loadu_ps(recip_zz + i);
        /* ...multiplica e empacota... */
    }
Além de escrever essa versão, eu também escrevi uma alternativa mais boba (multiplicar tudo em ordem natural e reordenar depois), e coloquei as duas num teste isolado para comparar.
escalar           : 1,107 ms
com gather        : 0,135 ms
contíguo+reordena : 0,181 ms
O gather ganhou. Trinta por cento mais rápido que a "alternativa boba", e oito vezes mais rápido que o escalar.
Fui colocar no codec de verdade, esperando ver o encode cair mais um tanto. E o que aconteceu foi exatamente isso que estamos vendo abaixo:
Imagem    │ Com gather │ Contíguo  │
──────────┼────────────┼───────────┤
portrait  │  3,93 ms   │  3,80 ms  │
smooth    │ 10,82 ms   │ 10,64 ms  │
texture   │  4,77 ms   │  5,08 ms  │
micro     │  4,32 ms   │  4,25 ms  │
Empate. As duas versões ficam dentro de cinco por cento uma da outra, e nem sempre para o mesmo lado. 😐
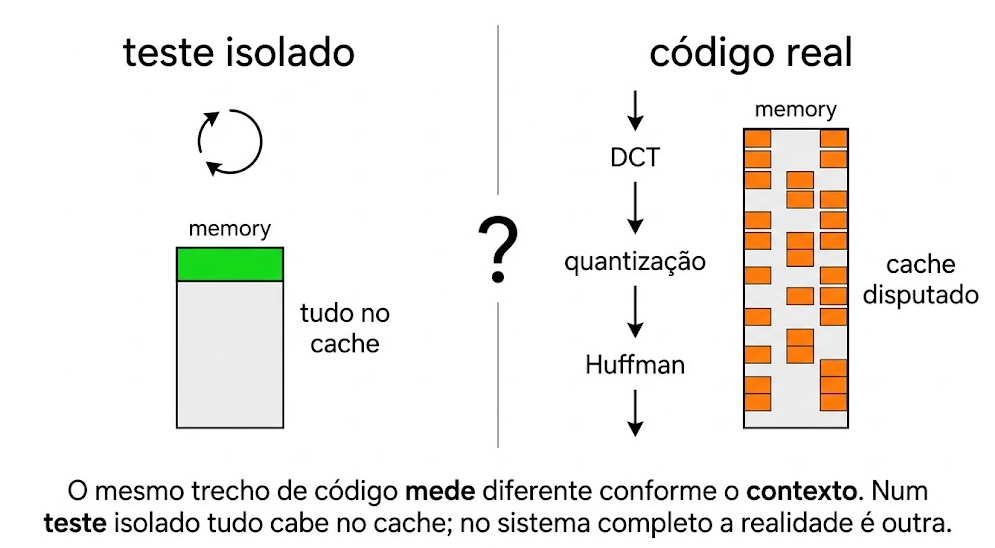
O teste isolado tinha me dito uma coisa, e o código real disse outra. Complicado isso aí, né?
Por que o teste isolado enganou
A explicação é uma armadilha clássica de medição.
Um teste isolado roda a mesma função milhares de vezes seguidas, sempre sobre o mesmo pedacinho de memória. Nessas condições tudo fica na parte mais rápida do cache, o processador aprende o padrão de acesso, e a instrução aparece no seu melhor cenário possível.
No codec de verdade a função é chamada uma vez por bloco, entre uma DCT e uma escrita de bits, com muito mais dados circulando pela memória. O cenário ideal simplesmente não existe. 🎭
E tem mais um detalhe que eu descobri comparando anotações de execuções anteriores: o gather rende de formas muito diferentes conforme o processador.
Numa máquina que usei antes nesta série, a mesma comparação mostrou o gather sendo mais de duas vezes mais lento que a alternativa boba. Nesta nova máquina ele ficou mais rápido no teste isolado e empatado no código real.
Não é que uma medição estava errada e a outra certa, pois as duas estavam certas, cada uma no seu contexto.
💡 A lição, e ela vale para qualquer otimização: um teste isolado é útil para entender uma função, mas quem decide é a medição no sistema completo. E quando duas alternativas empatam, a escolha certa é a que depende de menos coisas.
Foi por isso que fiquei com a versão sem gather. Ela não depende do gather ser bem implementado no processador de quem roda o código, e o resultado dela é bem mais previsível entre máquinas diferentes:
// Quantizing in natural order keeps every load contiguous, and the
// values are narrowed to 16 bits before the reordering pass, so half
// as many bytes move around.
    short natural[64];
    for (int i = 0; i < 64; i += 16) {
        __m256i low = _mm256_cvtps_epi32(
            _mm256_mul_ps(_mm256_loadu_ps(coef + i), _mm256_loadu_ps(recip + i)));
        __m256i high = _mm256_cvtps_epi32(
            _mm256_mul_ps(_mm256_loadu_ps(coef + i + 8), _mm256_loadu_ps(recip + i + 8)));

        __m256i packed = _mm256_packs_epi32(low, high);
        // packs works within 128 bit lanes, so the halves need one
        // more shuffle to come out in sequence.
        packed = _mm256_permute4x64_epi64(packed, 0xD8);
        _mm256_storeu_si256((__m256i *)(natural + i), packed);
    }

    for (int i = 0; i < 64; i++) out[i] = natural[zigzag[i]];
Repara num detalhe que ajuda bastante: a reordenação acontece depois de os valores virarem inteiros de 16 bits. Isso faz o passo espalhado mover metade dos bytes que moveria se acontecesse antes.
Uma quarta melhoria, pequena e discreta
Já que estávamos ali, tem um detalhe fácil de aproveitar.
Para montar um bloco 8x8, a gente lia os pixels um a um e convertia cada um para float. Mas oito bytes consecutivos cabem numa carga só, e existe uma instrução que converte oito inteiros para oito floats de uma vez:
// Loads an 8x8 patch of bytes as floats, one row per instruction.
__attribute__((target("avx2")))
static void load_block_avx2(const unsigned char *src, int stride, float block[64]) {
    for (int r = 0; r < 8; r++, src += stride) {
        __m128i bytes = _mm_loadl_epi64((const __m128i *) src);
        _mm256_storeu_ps(block + r*8,
                         _mm256_cvtepi32_ps(_mm256_cvtepu8_epi32(bytes)));
    }
}
São 64 conversões que acabaram virando oito instruções. Só que esse caminho só vale para blocos que estão inteiramente dentro da imagem, porque os blocos da borda precisam daquele tratamento de repetição de pixel que a gente fez no artigo 16.
Então o código escolhe: bloco interior vai pelo caminho rápido, bloco de borda continua pelo caminho antigo.
            int interior = (block_x + 1) * 8 <= plane->width &&
                           (block_y + 1) * 8 <= plane->height;
#if defined(__x86_64__) || defined(__i386__)
            if (interior && n148_cpu_level() >= N148_CPU_AVX2) {
                load_block_avx2(...);
            } else
#endif
            {
                /* ...caminho antigo, com tratamento de borda... */
            }
Como a esmagadora maioria dos blocos de uma imagem é interior, o caminho rápido cobre quase tudo, e as bordas continuam corretas. ✅
Os resultados
Somando as três frentes e a melhoria da carga de bloco:
Imagem    │ Encode 22 │ Encode 23 │  Ganho  │ Decode 22 │ Decode 23 │ Ganho
──────────┼───────────┼───────────┼─────────┼───────────┼───────────┼───────
portrait  │  5,71 ms  │  3,06 ms  │  1,87x  │  8,47 ms  │  7,18 ms  │ 1,18x
smooth    │ 15,79 ms  │  8,19 ms  │  1,93x  │ 23,31 ms  │ 20,19 ms  │ 1,15x
texture   │  6,58 ms  │  3,80 ms  │  1,73x  │  9,07 ms  │  8,08 ms  │ 1,12x
micro     │  6,03 ms  │  3,50 ms  │  1,72x  │  8,59 ms  │  7,56 ms  │ 1,14x
O encode quase dobrou de velocidade. Comparando com os 5% do artigo passado, dá para ver o que muda quando a otimização acerta o alvo certo. 🎯
Sobre a saída, e uma diferença honesta
A validação de sempre, agora com um detalhe novo para relatar:
Imagem    │ Artigo 22 │ Artigo 23 │ PSNR
──────────┼───────────┼───────────┼───────
portrait  │ 26.708 B  │ 26.706 B  │ igual
smooth    │ 30.805 B  │ 30.807 B  │ igual
texture   │ 54.318 B  │ 54.318 B  │ igual
micro     │ 35.492 B  │ 35.492 B  │ igual
colorful  │ 25.933 B  │ 25.934 B  │ igual
O PSNR ficou idêntico em todas, e os tamanhos oscilaram em alguns bytes, no máximo dois em 26 mil.
Mas dai você pode estar se perguntando.... de onde vem essa diferencinha?
Ela vem do ponto fixo. A versão original fazia as contas em double, e a nova faz em inteiros de 16 casas binárias. Quando um valor cai exatamente no meio do caminho entre dois inteiros, as duas abordagens podem escolher lados diferentes.
Isso muda um pixel aqui e ali no canal de croma, o que muda um coeficiente, o que faz o Huffman gastar um bit a mais ou a menos. Não é erro, é uma escolha de precisão diferente, e ela mexe em fração de por cento.
Mais importante que isso: os dois caminhos do codec continuam concordando entre si, o que é a propriedade que realmente importa.
=== escalar vs AVX2 ===
portrait:
  nivel 0: 26540 bytes  PSNR 32.0617 dB
  nivel 2: 26540 bytes  PSNR 32.0617 dB
texture:
  nivel 0: 54180 bytes  PSNR 27.1186 dB
  nivel 2: 54180 bytes  PSNR 27.1186 dB
Mesmos bytes, mesmo PSNR. Um arquivo gerado numa máquina moderna abre igualzinho numa máquina antiga. ✅
Por que o decode ganhou menos
Ficou aquela pergunta pendente: por que o encode quase dobrou e o decode melhorou só 15%?
O perfil responde, dê uma olhada nessa tabela abaixo:
ENCODE                    │ portrait │ smooth
──────────────────────────┼──────────┼──────────
Conversão de cor          │  1,12 ms │  3,61 ms
Resto do encode           │  1,98 ms │  4,60 ms

DECODE                    │ portrait │ smooth
──────────────────────────┼──────────┼──────────
Entropia e IDCT           │  2,07 ms │  4,47 ms
merge_channels            │  4,92 ms │ 15,71 ms
A conversão de cor caiu de 2,43 para 1,12 ms no encode, ficando menos da metade. No decode, o merge_channels caiu de 6,10 para 4,92 ms, uma queda bem mais modesta.
O motivo é que o merge_channels faz duas coisas: o upsampling do croma e a conversão de cor. A gente vetorizou a segunda, e a primeira continua escalar.
Ou seja, sobrou trabalho ali. Só que a essa altura já não é o maior problema do codec, e existe uma abordagem completamente diferente esperando na fila. 😉
Spoilers...
O que vem por aí
Até agora, ao longo de cinco artigos, a gente explorou duas estratégias.
A primeira foi fazer menos trabalho, com os algoritmos melhores, os resultados guardados e as tabelas de consulta. A segunda foi fazer várias coisas por instrução, que é o SIMD dos dois últimos artigos.
No próximo artigo entra a terceira, e talvez a mais óbvia de todas quando a gente para para pensar: usar mais de um núcleo do processador. 🧵
O seu computador provavelmente tem quatro, oito ou mais núcleos, e o nosso codec (atualmente) usa exatamente (apenas) um deles.
Só que essa estratégia traz perguntas novas, e algumas respostas surpreendentes, porque nem tudo dentro de um codec pode ser dividido, e vou mostrar exatamente o que não dá e por quê.
Também vou contar um caso em que adicionar mais núcleos deixou o programa mais lento, que é o tipo de resultado que a gente só entende depois de investigar. 🤔
Repositório no GitHub
E sim, você pode acompanhar a evolução desse CODEC de imagens em um repositório no GitHub, commit por commit 👋
Segue o link abaixo do commit desse artigo, onde vetorizamos as duas conversões de cor, a quantização e a carga dos blocos:
Resumo
Recapitulando:
- A conversão de cor era o maior custo do codec, com 42% do encode e boa parte do decode, não porque a conta seja difícil, mas porque ela roda para cada pixel.
- A instrução pshufb separa os canais entrelaçados usando um mapa de bytes, deixando os dados prontos para o SIMD.
- O ponto fixo permite fazer contas com números quebrados usando apenas inteiros, o que dobra quantos pixels cabem em cada registrador.
- O empacotamento com saturação faz o clamp de 0 a 255 de graça, eliminando seis comparações por pixel.
- Na volta, os mesmos mapas invertidos montam os pixels entrelaçados, e um ou binário junta os três canais.
- O padrão laço vetorial mais rabo escalar é obrigatório, porque quase nenhuma imagem tem largura múltipla de oito.
- A armadilha do gather: uma instrução feita para o problema, que num teste isolado ganhou e no código real empatou. Testes isolados exageram o cenário favorável.
- Entre duas alternativas empatadas, escolha a que depende de menos coisas.
- O ponto fixo muda a saída em fração de por cento por arredondamento, e isso precisa ser relatado, não escondido.
- Resultado: encode quase 2x mais rápido, decode 1,15x, com escalar e AVX2 produzindo arquivos idênticos.
Se tem uma coisa que eu levo destes dois artigos de SIMD, é que a técnica é a parte fácil.
O difícil é descobrir onde aplicar, e ter a disciplina de medir no lugar certo antes de acreditar em qualquer resultado.
No próximo artigo a gente encerra a jornada de otimização com o paralelismo.
Até lá! 👋