
O julgamento: N.148i contra JPEG e JPEG XL
Olá leitor, seja muito bem vindo de volta a mais uma etapa da nossa jornada aqui no Portal da Micilini! 😊
Este é o vigésimo quinto artigo da nossa série, e é o dia que a gente vinha adiando desde o artigo 18.
Naquela época eu tinha tudo pronto para o benchmark, os scripts na mão e as imagens escolhidas. Aí resolvi medir o tempo, levei um susto, e engavetei o julgamento para consertar a velocidade primeiro.
Foram seis artigos de otimização. Trocamos a DCT, criamos caches, reescrevemos a leitura e a escrita de bits, descemos ao SIMD e paralelizamos o que dava para paralelizar.
Hoje a gente descobre se valeu a pena. 🥊
E eu adianto uma coisa: o resultado tem uma vitória clara, uma derrota clara, e uma descoberta no meio que eu acho mais interessante que as duas.
Pega o café que hoje o artigo é longo e cheio de número! ☕
Como esse benchmark foi feito?
Antes dos resultados, preciso falar de método. Um benchmark mal feito é pior que benchmark nenhum, porque ele produz um número que parece verdade e não é.
Então vale explicar as decisões, porque cada uma delas foi tomada para tornar o resultado mais difícil de ser favorável a nós.
Decisão 1: comparar na mesma qualidade, não na mesma configuração
É tentador comparar o nosso codec na qualidade 50 contra o JPEG na qualidade 50. E é errado.
O número de qualidade não significa a mesma coisa em codecs diferentes, porque cada um mapeia esse valor para uma agressividade de quantização própria. O 50 do JPEG XL não é o nosso 50.
Comparar assim é como avaliar dois carros dizendo que os dois estavam com o acelerador na metade. 🚗
O jeito certo é medir curvas. Cada codec roda em cinco qualidades diferentes, e para cada ponto a gente anota quanto ele ocupou e que qualidade entregou. Depois compara as curvas inteiras.
A medida que resume isso se chama BD-rate, e ela responde exatamente a pergunta certa: quantos por cento a mais ou a menos de bits um codec precisa para entregar a mesma qualidade?
- BD-rate de -10%: o codec precisa de 10% menos bits para a mesma qualidade. Melhor.
- BD-rate de 0%: empate.
- BD-rate de +30%: precisa de 30% mais bits. Pior.
Decisão 2: dar aos concorrentes a melhor configuração deles
Aqui é onde a maioria dos benchmarks caseiros escorrega, quase sempre sem má intenção.
O libjpeg-turbo foi configurado com 4:2:0 e tabelas de Huffman otimizadas, que é exatamente a configuração do nosso codec. Se eu comparasse com o JPEG no modo padrão, nossa vantagem apareceria inflada de graça, porque estaríamos comparando com uma configuração que ninguém sério usa.
O JPEG XL tem um parâmetro de esforço que muda drasticamente tempo e compressão. Medir só o mais lento faria ele parecer pior em velocidade do que precisa ser, e medir só o rápido faria ele parecer pior em compressão. Então medimos dois níveis, esforço 3 e esforço 7, e reportamos os dois.
Decisão 3: medir o codec, e não o embrulho
Essa a gente aprendeu apanhando, ainda durante a fase de otimização.
Descobrimos que a mesma libjpeg-turbo, chamada por bibliotecas de ligação diferentes, variava até três vezes no tempo. O codec era o mesmo; o que mudava era o custo de alocar buffers e atravessar a fronteira entre linguagens.
Por isso as bibliotecas foram ligadas no mesmo processo, chamadas pela API em C, sem ferramentas de linha de comando e sem embrulhos. As imagens são carregadas na memória antes de o cronômetro começar, e o disco fica de fora da medição.
Decisão 4: separar eficiência de throughput
Esse cuidado é sutil e importa muito.
Comparar o nosso codec usando dez threads contra um concorrente que usa uma só não é injusto, porém responde uma pergunta diferente. São dois eixos distintos:
- Eixo A, eficiência: todos com uma thread. Mesma quantidade de CPU para todos. Mede quão bom é o algoritmo.
- Eixo B, throughput: cada um com o paralelismo que oferece. Mede o que o usuário sente no relógio.
Os dois são legítimos, e misturar os dois num número só é o tipo de coisa que faz um benchmark parecer melhor do que é. Neste artigo eles aparecem sempre separados. 🫡
Decisão 5: usar métricas que discordam entre si
Uma métrica só conta uma parte da história, então medimos seis:
- PSNR em RGB e no canal Y, que é o erro matemático puro
- SSIM e MS-SSIM, que olham estrutura
- SSIMULACRA2 e Butteraugli, que são modelos perceptuais modernos, os mesmos usados pela equipe do JPEG XL
Elas não concordam entre si, e isso é característica, não defeito. PSNR e SSIM tendem a premiar suavização, enquanto as perceptuais punem perda de estrutura e artefatos visíveis.
Quando duas métricas apontam vencedores diferentes, isso é um resultado para reportar, e não um convite para escolher a que favorece. 🎯
O conjunto de imagens
Um benchmark só significa alguma coisa se o conjunto for variado, então o corpus tem 120 imagens divididas igualmente em oito categorias, quinze em cada:
Categoria                          │ Imagens
───────────────────────────────────┼─────────
Retratos históricos e obras 2D     │   15
Paisagens naturais                 │   15
Urbano e arquitetura               │   15
Texturas de alta frequência        │   15
Superfícies suaves e degradês      │   15
Detalhe fino                       │   15
Texto e bordas nítidas             │   15
Cores saturadas e dessaturadas     │   15
São 53,7 milhões de pixels no total, com resoluções variando de 288 a 1.036 pixels de largura. Todas as imagens têm licença livre: domínio público, CC0 ou CC BY, e cada uma está registrada com origem, autor e licença.
Também guardamos o SHA-256 de cada arquivo convertido, junto com uma ferramenta que reconstrói o conjunto inteiro a partir do manifesto e confere os hashes. Assim qualquer pessoa reproduz exatamente o mesmo experimento. 🔬
Antes de medir: as verificações de correção
Nenhum número de velocidade vale coisa alguma se a saída estiver errada. Então antes de qualquer medição, uma bateria de verificações precisou passar:
Verificação                              │ Resultado
─────────────────────────────────────────┼───────────
Sentinela de tamanho conhecido           │ PASS (2.290 bytes exatos)
Suíte de validação                       │ PASS (0 falhas)
Caminho escalar contra AVX2              │ PASS (idênticos byte a byte)
Dimensão não múltipla de 8 (317x241)     │ PASS
Croma 4:4:4, 4:2:2 e 4:2:0               │ PASS
Uma thread contra quatro                 │ PASS (arquivos idênticos)
Consumo do bitstream                     │ PASS (consumido = escrito)
Determinismo nas 120 imagens             │ PASS (zero divergências)
Aquela linha de uma thread contra quatro merece atenção. Ela garante que o paralelismo não mudou nada na saída, o que seria um desastre silencioso: o arquivo gerado numa máquina abriria diferente em outra. ✅
Round 1: N.148i contra libjpeg-turbo
Vamos ao confronto mais direto, já que o N.148i é essencialmente um JPEG feito por nós.
Primeiro a compressão, com o BD-rate em cada uma das seis métricas. Negativo significa que a gente precisa de menos bits:
Métrica       │ BD-rate  │ Vitórias/Empates/Derrotas
──────────────┼──────────┼──────────────────────────
PSNR RGB      │ -1,384%  │  96 / 24 / 0
PSNR Y        │ -1,325%  │  96 / 24 / 0
SSIM          │ -1,599%  │  98 / 22 / 0
MS-SSIM       │ -1,403%  │  99 / 21 / 0
SSIMULACRA2   │ -1,390%  │  94 / 26 / 0
Butteraugli   │ -1,355%  │  76 / 35 / 9
Todas as seis métricas apontam para o mesmo lado. 🎉
E olha a coluna da direita: em cinco das seis métricas, zero derrotas em 120 imagens. A única exceção é o Butteraugli, com nove derrotas, mas fique tranquilo que eu já volto nisso...
O ganho é modesto, cerca de 1,4%, e isso é esperado. O N.148i usa o mesmo algoritmo do JPEG, então seria muito estranho se a diferença fosse grande. A pequena vantagem vem do nosso formato ser mais enxuto, sem os marcadores e segmentos que o JPEG carrega.
Agora a velocidade, no eixo A, com todos usando uma thread:
Operação │ Diferença N.148i │ Vitórias/Empates/Derrotas
─────────┼──────────────────┼──────────────────────────
encode   │     -25,844%     │  120 / 0 / 0
decode   │      -6,700%     │  118 / 2 / 0
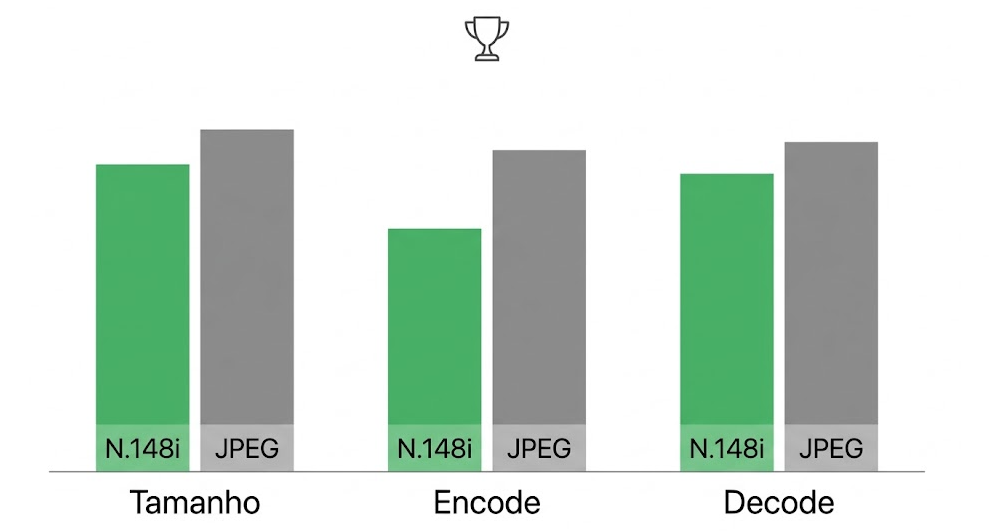
Encode 26% mais rápido, com 120 vitórias em 120 imagens. Nenhuma derrota, nenhum empate.
Em throughput absoluto, isso dá:
Codec   │ Encode    │ Decode
────────┼───────────┼───────────
N.148i  │ 238 MP/s  │ 406 MP/s
JPEG    │ 173 MP/s  │ 379 MP/s
Colocando tudo junto: o N.148i vence o libjpeg-turbo simultaneamente em tamanho, encode e decode. 🏆
Esse era o objetivo lá do artigo 18, e ele está cumprido com evidência forte: 120 imagens, cinco pontos de qualidade cada, seis métricas, e testes estatísticos com valores-p na casa de 10 elevado a menos 21.
Round 2: N.148i contra JPEG XL
Agora o confronto com um formato de outra geração, lançado em 2022, e aqui a história é bem diferente.
Primeiro a compressão, comparando com os dois níveis de esforço. Positivo significa que a gente precisa de mais bits, ou seja, perdemos:
Métrica       │ vs JXL esforço 3 │ vs JXL esforço 7
──────────────┼──────────────────┼──────────────────
PSNR RGB      │     +34,586%     │     +38,594%
PSNR Y        │     +41,963%     │     +40,982%
SSIM          │     +17,803%     │     +31,716%
MS-SSIM       │     +12,868%     │     +20,697%
SSIMULACRA2   │     +30,183%     │     +41,517%
Butteraugli   │     +64,079%     │     +71,880%
Perdemos, e não é pouco. Precisamos de algo entre 13% e 72% mais bits que o JPEG XL para entregar a mesma qualidade. 😐
Um ponto concreto ajuda a visualizar. Com aproximadamente 2,3 bits por pixel, o N.148i entrega 36,6 dB de PSNR e o JPEG XL entrega 38,2 dB. Ele consegue 1,6 dB a mais no mesmo espaço.
Agora a velocidade, e é aqui que a mesa vira:
Comparação          │ Encode        │ Decode
────────────────────┼───────────────┼───────────────
vs JXL esforço 3    │  7,34x mais rápido │ 10,79x mais rápido
vs JXL esforço 7    │ 89,29x mais rápido │  9,97x mais rápido
Não é engano de digitação: no esforço 7, o nosso encode é quase noventa vezes mais rápido. 🚀
Em throughput absoluto fica assim:
Codec         │ Encode      │ Decode
──────────────┼─────────────┼────────────
N.148i        │ 238,3 MP/s  │ 405,6 MP/s
JPEG XL e3    │  34,0 MP/s  │  37,7 MP/s
JPEG XL e7    │   2,7 MP/s  │  42,9 MP/s
O resumo honesto do round 2 é este: o N.148i ocupa o extremo de baixa latência e o JPEG XL ocupa o extremo de eficiência de compressão. São posições diferentes no mesmo espaço de projeto, e não existe um vencedor absoluto.
Por que perdemos para o JPEG XL?
Vale explicar, porque o motivo não é falta de capricho na implementação.
O N.148i usa a receita do JPEG de 1992: transformada de 8x8 fixo, quantização uniforme e codificação de Huffman. Nós espremeremos essa receita até o limite ao longo de seis artigos.
O JPEG XL tem coisas que a nossa receita simplesmente não possui, tais como:
- Transformadas de tamanho variável, de 4x4 até 256x256, escolhendo o melhor tamanho por região
- Predição intra-bloco, que estima o conteúdo de um bloco a partir dos vizinhos e codifica só a diferença
- Quantização adaptativa, que gasta mais bits onde o olho percebe erro
- Codificação aritmética, que quebra o piso de um bit por símbolo que o Huffman tem
- Espaço de cor perceptual próprio, calibrado com experimentos de percepção
Não é uma implementação melhor da mesma ideia. É uma ideia diferente, fruto de anos de trabalho de dois times inteiros, o do PIK no Google e o do FUIF no Cloudinary, que se fundiram no projeto.
Perder para ele (JPEG XL) em compressão era o resultado esperado. O que talvez não fosse esperado é o tamanho da vantagem que sobra do nosso lado em velocidade. ⚖️
A descoberta do meio: as métricas discordam
Essa é a parte que eu achei mais interessante do benchmark inteiro.
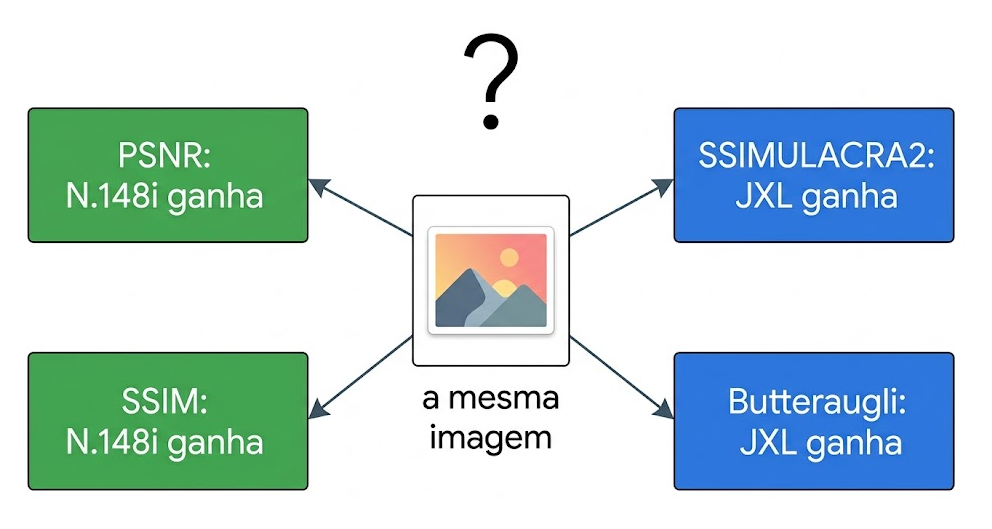
Repara de novo na tabela do round 2. Contra o JXL esforço 3, o MS-SSIM diz que perdemos por 12,9%, enquanto o Butteraugli diz que perdemos por 64,1%. É a mesma comparação, com as mesmas imagens, e uma métrica enxerga um buraco cinco vezes maior que a outra.
O caso individual mais extremo é a imagem corpus-0107.ppm, uma composição abstrata bem colorida:
corpus-0107 contra JXL e3:

  PSNR RGB      -40,78%   ← favorável ao N.148i
  SSIM          -27,95%   ← favorável ao N.148i
  SSIMULACRA2   +69,01%   ← favorável ao JXL
  Butteraugli  +163,35%   ← favorável ao JXL
Na mesma imagem, duas métricas dizem que ganhamos com folga e duas dizem que perdemos feio. 🤯
Como isso é possível? A hipótese compatível com a imagem é que PSNR e SSIM medem semelhança média e acabam premiando suavização, enquanto as métricas perceptuais reagem a estrutura e a artefatos nas transições de cor saturada.
Nós suavizamos, o JXL preserva a estrutura, e cada família de métrica premia um comportamento.
Esse é um resultado sério, e não um detalhe. Ele significa que a pergunta qual codec comprime melhor não tem resposta única, porque esse tipo de situação depende do que você entende por melhor.
Onde ganhamos mais e onde ganhamos menos?
Como o corpus foi dividido em categorias, dá para ver se o resultado muda conforme o tipo de imagem.
A resposta curta é que nenhuma categoria inverte o vencedor. O N.148i ficou melhor que o JPEG nas oito categorias e pior que o JXL nas oito.
A margem, porém, muda bastante:
Contra JPEG          │ PSNR RGB │  SSIM   │ Butteraugli
─────────────────────┼──────────┼─────────┼─────────────
Suaves e degradês    │  -2,77%  │ -4,09%  │   -2,67%
Texturas de alta freq│  -1,02%  │ -1,05%  │   -0,70%
Ou seja, a nossa vantagem sobre o JPEG vem mais de regiões suaves que de detalhe fino. Em textura pesada a diferença quase desaparece.
Os extremos individuais também contam algo. O melhor caso contra o JPEG foi a imagem corpus-0073, de nuvens mesosféricas polares, com -12,58% em PSNR RGB. O pior foi justamente aquela composição colorida, com +11,79% em Butteraugli.
Aquelas nove derrotas em Butteraugli que apareceram no round 1 se concentram em imagens com cores saturadas e transições fortes. É o mesmo padrão da discordância entre métricas, aparecendo de novo. 🎨
O ponto fraco: o paralelismo
Preciso reportar o eixo em que o N.148i vai pior, e ele é o paralelismo.
A varredura de threads, sobre o corpus inteiro:
Threads │ Encode    │ Speedup │ Eficiência
────────┼───────────┼─────────┼───────────
   1    │ 203,4 ms  │  1,000x │   100,0%
   2    │ 158,9 ms  │  1,280x │    64,0%
   4    │ 193,5 ms  │  1,051x │    26,3%
   8    │ 151,8 ms  │  1,339x │    16,7%
  10    │ 146,8 ms  │  1,386x │    13,9%
Com dez núcleos, o encode fica apenas 1,386 vez mais rápido. E o decode é pior ainda, chegando a 1,022 vez, praticamente nada.
A explicação já apareceu no artigo passado: boa parte do codec é sequencial por construção. A escrita dos bits não divide, e a cadeia do DC também não, porque cada bloco depende do anterior.
Repara também naquela linha de quatro threads, que ficou pior que a de duas. É o processador híbrido de novo, com dois núcleos rápidos e oito de eficiência, e o nosso divisor de trabalho tratando todos como iguais.
E aqui vai um aviso de honestidade: o eixo B, das medições com paralelismo, não atingiu o alvo de ruído abaixo de 1% que a gente estabeleceu, e embora as margens contra o JXL sejam grandes demais para mudar de sinal, os percentuais exatos do multi-thread não têm o mesmo grau de evidência do eixo A, motivo pelo qual este artigo usa o eixo A nas afirmações principais. 🫡
O que este benchmark não mede
Todo benchmark tem fronteiras, e esconder elas seria justamente o tipo de coisa que a gente evitou o artigo inteiro.
- Foi medida uma única CPU móvel x86-64. Processadores ARM, servidores ou máquinas sem AVX2 podem mudar as proporções.
- A frequência do processador não foi travada. A alternância pareada reduz o viés, mas não elimina a variância.
- 118 das 120 imagens de origem eram JPEG. O redimensionamento quebra a grade original, porém não apaga a compressão prévia. Um conjunto nascido em RAW ou PNG poderia mudar o ranking.
- As imagens vão até 1,3 megapixel. Não medimos fotos de dezenas de megapixels, miniaturas muito pequenas, HDR, alpha nem modo sem perdas.
- O JPEG XL foi testado só na versão 0.12.0, com dois esforços. Uma versão futura pode deslocar tempo e taxa.
- O tempo inclui criar e destruir o contexto de uma imagem. Um serviço que reaproveite estado teria outro throughput.
O veredito
Juntando tudo:
Confronto          │ Compressão      │ Velocidade
───────────────────┼─────────────────┼──────────────────
vs libjpeg-turbo   │ VENCEMOS (-1,4%)│ VENCEMOS (26% enc)
vs JPEG XL         │ perdemos (13-72%)│ VENCEMOS (7x a 89x)
Contra o libjpeg-turbo, que é o padrão da indústria rodando em bilhões de dispositivos: vitória nos três eixos, em 120 imagens, sem uma única derrota nas métricas principais.
Contra o JPEG XL, que é um formato de outra geração: derrota clara em compressão, vitória enorme em velocidade.
E aquela pergunta lá do artigo 18, sobre se o nosso codec era bom, agora tem resposta com número: ele é. Um codec escrito do zero, linha por linha, em vinte e cinco artigos, que bate o padrão da indústria em eficiência e em velocidade ao mesmo tempo. 🏆
O que eu levo desta série de benchmark
Se tem uma coisa que esse trabalho me ensinou, é que medir direito é mais difícil que otimizar.
Otimizar tem um alvo claro e um resultado óbvio: ou ficou mais rápido, ou não ficou. Medir exige escolher a configuração justa do concorrente, escolher a métrica, separar os eixos, controlar o ruído, e resistir à tentação de parar de investigar quando o número já está bom.
A cada decisão desse benchmark eu escolhi o caminho que tornava o resultado mais difícil para nós. Dar ao JPEG as tabelas otimizadas, medir o JXL nos dois esforços, incluir métricas perceptuais que sabidamente não nos favorecem, e reportar o eixo que não convergiu.
É por isso que o resultado vale alguma coisa. Um número favorável que não sobrevive a escrutínio não vale nada. 🔬
Repositório no GitHub
E sim, você pode acompanhar a evolução desse CODEC de imagens em um repositório no GitHub, commit por commit 👋
Além do código, o repositório traz agora o relatório completo do benchmark, os dados brutos, o manifesto das 120 imagens com licenças e hashes, e a ferramenta que reconstrói o conjunto:
Resumo
Recapitulando o dia do julgamento:
- Comparamos na mesma qualidade reconstruída, usando BD-rate, e não na mesma configuração, porque o número de qualidade significa coisas diferentes em cada codec.
- Demos a cada concorrente a melhor configuração dele: JPEG com tabelas otimizadas e JPEG XL em dois níveis de esforço.
- Medimos as bibliotecas ligadas no mesmo processo, sem embrulhos, porque a mesma libjpeg varia até três vezes conforme o binding.
- Separamos eficiência de throughput, e nunca apresentamos um como se fosse o outro.
- Usamos seis métricas, incluindo perceptuais que não nos favorecem.
- Contra o libjpeg-turbo: vitória nos três eixos. 1,4% menos bits, 26% mais rápido no encode, 6,7% no decode, sem derrota em 120 imagens.
- Contra o JPEG XL: derrota em compressão (13% a 72% mais bits) e vitória em velocidade (7x a 89x mais rápido).
- As métricas discordam, e numa mesma imagem duas apontaram o N.148i e duas apontaram o JXL.
- O paralelismo é o ponto fraco, com apenas 1,386x usando dez núcleos, limitado pelas partes sequenciais do codec.
E é assim que a gente encerra a Fase 4 da nossa jornada. 🎊
Começamos no artigo 1 explicando o que é um pixel, e chegamos aqui com um codec autoral, medido com rigor contra os padrões da indústria, e vencendo um deles.
Mas a série não acabou.
Sabe aquela lista de coisas que o JPEG XL tem e nós não temos, lá do round 2?
Olha ela de novo: transformadas de tamanho variável, predição intra-bloco, quantização adaptativa e codificação aritmética.
Essa lista não é APENAS uma lista de derrotas. É o roteiro da Fase 5. 🗺️
Sendo assim, no próximo artigo a gente começa pela predição intra-bloco, que é a maior fonte isolada de ganho dos formatos modernos e, ao mesmo tempo, uma das ideias mais bonitas de compressão que existem: prever o conteúdo de um bloco olhando apenas para os vizinhos, e guardar só o erro dessa previsão.
O buraco para o JPEG XL está medido e quantificado. Agora a gente sabe exatamente o que precisa construir para fechar ele. 🎯
Resumindo: Na FASE 5 nós vamos buscar essa vitória contra o JPEG XL e o WebP também!
Prepara o café ☕, porque a Fase 5 começa agora.
Até a próxima lição! 👋