
Afiando o decoder: lookup de Huffman, blocos chapados e upsampling inteiro
Olá leitor, seja muito bem vindo de volta a mais uma etapa da nossa jornada aqui no Portal da Micilini! 😊
Este é o vigésimo primeiro artigo da nossa série, e o terceiro da nossa empreitada de otimização.
Nos dois artigos anteriores a gente cuidou do encoder: trocamos a DCT pela AAN, embutimos a escala na tabela de quantização, criamos o cache de coeficientes e reescrevemos a escrita de bits.
O encode saiu de 68 ms para pouco mais de 5 ms.
Hoje é a vez do decoder, que por sua vez ficou para trás e virou, disparado, o lado lento do nosso codec. 🐢
E como prometi, tem uma história esperando: uma otimização que funcionou, ficou mais rápida, produziu arquivos exatamente iguais... e mesmo assim piorou a imagem em 0,15 dB.
Descobrir de onde vinha essa perda foi um dos momentos mais instrutivos que tive escrevendo esta série. 🔍
Sendo assim, pega o café e bora mais uma vez! ☕
O desequilíbrio
Vamos começar olhando onde o codec está hoje, voltando lá no fim do artigo 20, nós temos o seguinte:
Imagem    │  Encode  │  Decode
──────────┼──────────┼──────────
portrait  │  5,45 ms │ 11,49 ms
smooth    │ 15,48 ms │ 33,15 ms
texture   │  6,05 ms │ 13,12 ms
micro     │  6,23 ms │ 13,45 ms
Repara na assimetria: se você observar, poderá notar que o decode custa mais que o dobro do encode. 😬
Isso é o inverso do que se espera de um codec. Comprimir envolve decisões, como: escolher tabelas, contar frequências, avaliar opções. Descomprimir é só seguir instruções, e isso significaria que o decoder deveria ser o lado mais leve...
Dessa forma, investi um tempo instrumentando ele, e parece que o resultado foi bem direto:
Etapa                        │  portrait  │  smooth
─────────────────────────────┼────────────┼──────────
decode_image (entropia+IDCT) │   2,66 ms  │  5,64 ms
merge_channels               │   9,14 ms  │ 29,43 ms
Repare que o merge_channels come 77% do tempo.
Mas dai você pode estar se perguntando... o que será que é esse tal de merge_channels?
Ele representa a nossa última etapa, responsável por pegar os planos Y, Cb e Cr, esticar os canais de cor de volta ao tamanho cheio (o upsampling) e converter tudo para RGB.
Ou seja: a parte que a gente considerava "o acabamento" é onde o tempo estava indo. De novo, a lição de sempre: sem medir, eu teria passado o dia otimizando a IDCT, que custa uma fração disso.
Levando os dados acima em consideração, nossa atuação mais correta é atacar em três frentes diferentes, começando da mais leve e indo até a mais pesada.
Frente 1: a tabela que responde de primeira
Comecemos pela decodificação Huffman.
Lembra de como ela funciona (artigo 17)?
Como os códigos têm tamanhos diferentes e não existe separador entre eles, o decoder lê um bit por vez e pergunta a cada bit: "o que eu tenho até agora já é um código válido?".
static int br_read_symbol(BitReader *reader, HuffDecodeTable *table) {
    int code = br_next_bit(reader);

    for (int length = 1; length <= 16 && !reader->failed; length++) {
        if (table->max_code[length] >= 0 &&
            code >= table->min_code[length] &&
            code <= table->max_code[length]) {
            /* achou */
        }
        code = (code << 1) | br_next_bit(reader);
    }
    ...
}
Funciona perfeitamente. Mas repara no custo: para um código de 8 bits, são 8 voltas de laço, cada uma lendo um bit e fazendo duas comparações.
Agora vem a observação que muda tudo: a maioria esmagadora dos símbolos usa códigos curtos. É literalmente o propósito do Huffman (dar códigos curtos ao que aparece muito).
Dito isso, e se a gente pudesse responder os códigos curtos de uma vez só? 🤔
Suponha que a gente espie os próximos 10 bits do fluxo, sem consumir. Esse número de 10 bits tem 1024 valores possíveis, certo?
Agora, para cada um desses 1024 valores possíveis, a gente pré-calcula: "se os próximos bits forem esses, qual símbolo é, e quantos bits ele consome?"
Aí a decodificação vira:
- Espia 10 bits. 👀
- Consulta a tabela nessa posição.
- Se tem resposta, pega o símbolo e avança o número de bits indicado. Pronto. ✅
Sem laço. Sem comparações, usando apenas um acesso a array. 🚀
"Mas peraí, e se o código tiver só 3 bits? Nesse caso, posso dizer que os outros 7 bits que eu espiei são de outros símbolos!"
Exatamente, e é aqui que está a beleza.
Se um código de 3 bits é 101101
Então a gente preenche as 128 posições com a mesma resposta: símbolo X, comprimento 3. Não importa o que vem depois; o decoder vai avançar só 3 bits e reavaliar. 🎯
Um código de comprimento L ocupa 2^(10 - L)
    // Every slot whose prefix matches a short code gets filled in.
    // A code of length L covers 2^(LOOKUP_BITS - L) consecutive slots,
    // because the bits after it can be anything.
    memset(table->fast_length, 0, sizeof(table->fast_length));

    code = 0;
    value_index = 0;
    for (int length = 1; length <= 16; length++) {
        for (int i = 0; i < spec->bits[length]; i++, value_index++, code++) {
            if (length <= LOOKUP_BITS) {
                int shift = LOOKUP_BITS - length;
                int start = code << shift;
                int end = start + (1 << shift);
                for (int slot = start; slot < end; slot++) {
                    table->fast_symbol[slot] = spec->values[value_index];
                    table->fast_length[slot] = (unsigned char)length;
                }
            }
        }
        code <<= 1;
    }
E os códigos maiores que 10 bits? Eles simplesmente não entram na tabela. As posições correspondentes ficam com comprimento zero, que é o sinal de "não sei, use o caminho lento":
static int br_read_symbol(BitReader *reader, HuffDecodeTable *table) {
    br_refill(reader);

    // One shot: peek at the next ten bits and see whether a short
    // code already claims that prefix.
    unsigned int window = br_peek(reader, LOOKUP_BITS);
    int length = table->fast_length[window];
    if (length) {
        br_skip(reader, length);
        return table->fast_symbol[window];
    }

    // Long code: walk the canonical ranges one length at a time.
    int code = br_next_bit(reader);
    for (length = 1; length <= 16 && !reader->failed; length++) {
        /* ...o caminho antigo, intacto... */
    }
}
O caminho lento continua ali, inteirinho. Ele só é raramente visitado. É a estrutura clássica de caminho rápido e caminho de exceção: otimize o caso comum, mantenha o caso raro correto. 🛤️
💡 Por que 10 bits? É um equilíbrio. Com menos bits, mais códigos caem no caminho lento. Com mais bits, a tabela cresce exponencialmente: 10 bits são 1024 posições (2 KB por tabela, cabendo bem no cache); 16 bits seriam 65 mil posições, e a tabela deixaria de caber, ficando mais lenta que o laço que ela substitui.
Um leitor de bits que lê oito bytes de uma vez
Junto com a LUT, vale arrumar o leitor, ou seja, fazer com que o nosso br_next_bit
    int bit = (reader->buffer[reader->byte_position] >>
               (7 - reader->bit_position)) & 1;
A ideia é a mesma do escritor de bits do artigo passado, ao contrário: usar um acumulador de 64 bits que guarda os próximos bits, e recarregar em blocos:
// Tops the accumulator back up. Near the end of the buffer it falls
// back to byte at a time so it never reads past the data.
static inline void br_refill(BitReader *reader) {
    if (reader->available > 56) {
        return;
    }

    if (reader->byte_position + 8 <= reader->size) {
        unsigned long long next = load_be64(reader->buffer + reader->byte_position);
        reader->accumulator |= next >> reader->available;
        reader->byte_position += (63 - reader->available) >> 3;
        reader->available |= 56;
        return;
    }

    while (reader->available <= 56) {
        /* ...caminho byte a byte no fim do buffer... */
    }
}
Os bits ficam alinhados à esquerda no acumulador, ou seja, o próximo bit a ser consumido está sempre no topo. Onde o fato de espiar vira apenas um único deslocamento:
static inline unsigned int br_peek(BitReader *reader, int count) {
    return (unsigned int)(reader->accumulator >> (64 - count));
}
Repara no cuidado com o fim do buffer: quando faltam menos de 8 bytes, ele volta ao modo byte a byte.
Sem essa guarda, o load_be64
Frente 2: o bloco que não precisa de transformada
Essa é a minha favorita do artigo, porque não otimiza nada, apenas evitando um trabalho que não precisava ser feito.
Lembra do que acontece quando a quantização é agressiva? A maioria dos coeficientes AC vira zero. E existe um caso limite muito comum: todos os AC viram zero, sobrando só o DC.
Agora pensa no que a IDCT faz nesse caso. Ela recebe uma matriz onde só o canto superior esquerdo tem valor, e o resto é zero. E o DC, lembra do artigo 9, representa a média do bloco.
Se só a média sobreviveu, a reconstrução é... a média, em todos os 64 pixels. O bloco inteiro vira uma cor chapada. 🎨
Ou seja: a gente estava rodando uma transformada completa, ou seja, duas passadas, 64 valores, para chegar num resultado que dá pra escrever direto.
    // A block whose AC coefficients all vanished reconstructs to a
    // single flat value: the transform of a constant is a constant.
    // At lower qualities this covers a large share of the image, and
    // skipping the transform there is free speed.
    if (!nonzero_ac) {
        float flat = zigzag[0] * quantization->multiplier[0] + 128.0f;
        if (flat < 0.0f) {
            flat = 0.0f;
        }
        if (flat > 255.0f) {
            flat = 255.0f;
        }
        for (int i = 0; i < 64; i++) {
            block[i] = flat;
        }
        return 1;
    }
Um detalhe importante que quase me pegou: aquele + 128.0f
A escala já está embutida no multiplier
Na minha primeira tentativa eu escrevi zigzag[0] * multiplier[0] * 0.125f + 128.0f/8
O PSNR despencou de 43 dB para 13 dB e a imagem virou um borrão cinza. Quando você embute um fator numa tabela, precisa lembrar que ele está lá em todos os lugares que usam a tabela. 😅
E aqui está o bônus: quanto pior a qualidade escolhida, mais blocos caem nesse caso, e mais rápido o decoder fica. É uma otimização que trabalha a favor exatamente quando o usuário mais quer velocidade.
Frente 3: o upsampling, e o bug dos 0,15 dB
Agora vamos focalizar no item que consome 77% do tempo do nosso decode.
Se você der uma olhada no código, vai perceber que o upsampling bilinear que a gente escreveu lá no artigo 18 era escrito dessa forma:
static double sample_bilinear(Plane *plane, double x, double y) {
    int x0 = (int)floor(x);
    int y0 = (int)floor(y);
    double fraction_x = x - x0;
    double fraction_y = y - y0;

    double top =
        plane_sample(plane, x0, y0) * (1.0 - fraction_x) +
        plane_sample(plane, x0 + 1, y0) * fraction_x;
    double bottom =
        plane_sample(plane, x0, y0 + 1) * (1.0 - fraction_x) +
        plane_sample(plane, x0 + 1, y0 + 1) * fraction_x;

    return top * (1.0 - fraction_y) + bottom * fraction_y;
}
Ele é bonito e genérico, funcionando para qualquer fator de escala, entretanto ele é caro, pois como vemos acima, são quatro chamadas de função, dois floor
Aqui vem a sacada. No nosso caso a escala não é qualquer uma: é exatamente metade. E quando você mapeia centros de pixel entre uma grade cheia e uma grade pela metade, as frações que aparecem são sempre as mesmas.
Vamos fazer a conta... Com escala 0,5, a coordenada do pixel px(px + 0.5) × 0.5 - 0.5
px = 0  →  -0,25   →  vizinho à esquerda, fração 0,75
px = 1  →   0,25   →  fração 0,25
px = 2  →   0,75   →  fração 0,75
px = 3  →   1,25   →  fração 0,25
Sempre 0,25 e 0,75, alternando. Ou seja, uma proporção fixa de 3 para 1. 🎯
E como isso vale nas duas direções, o resultado 2D é uma combinação fixa de quatro vizinhos com pesos 9, 3, 3 e 1 (que somam 16):
resultado = (9·a + 3·b + 3·c + 1·d) / 16Nenhum floor
Resultado....?
Eu implementei exatamente isso. Ficou muito mais rápido, os arquivos continuaram idênticos (claro, é só o decoder), e fui rodar a validação de qualidade como sempre fiz:
Imagem    │ Antes    │ Depois   │ Diferença
──────────┼──────────┼──────────┼───────────
smooth    │ 43,15 dB │ 43,00 dB │  -0,150
portrait  │ 35,52 dB │ 35,49 dB │  -0,030
micro     │ 37,35 dB │ 37,29 dB │  -0,060
texture   │ 35,24 dB │ 35,24 dB │  +0,000
Perdi qualidade. 😐
Não muito, 0,15 dB é imperceptível a olho nu. Mas a matemática deveria ser equivalente. Eu tinha derivado os pesos 9:3:3:1 da própria fórmula bilinear.
E tem uma coisa que me incomodou mais que a perda em si: a texturesmooth
Sendo considerado um erro que aparece só em imagens suaves, tá ai mais uma pista!
E onde estava esse bendito erro? Primeiro vamos olhar a minha versão bugada:
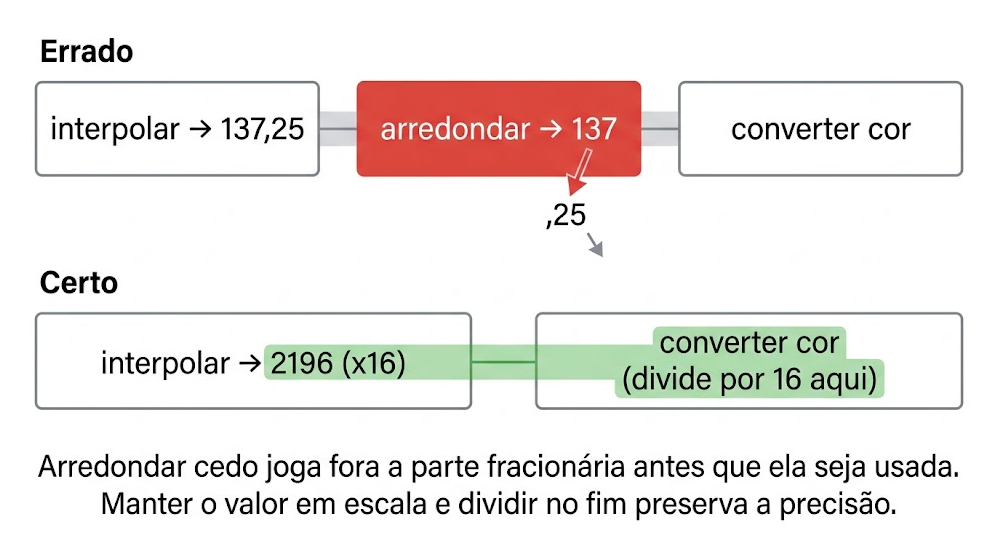
dst[x] = (unsigned char)((9 * a + 3 * b + 3 * c + d + 8) >> 4);Note que ele calcula o valor interpolado e guarda num único byte. Agora olha o que o código original fazia:
                blue_difference =
                    sample_bilinear(cb, chroma_x, chroma_y) - 128.0;
A sample_bilineardouble137,25, esse ,25
Na minha versão, esse 137,25 virava 137. A parte fracionária ia embora antes de ser usada.
E aí a pista faz sentido: numa imagem suave, os valores de croma vizinhos são próximos, então a interpolação cai bastante em valores fracionários, e perder essas frações importa. Numa textura caótica, os valores saltam tanto que a fração se perde no ruído de qualquer jeito. 🎯
E como correção: não arredonde cedo demais!
A solução é simples e elegante: não divida por 16.
Entregue a linha de croma ainda multiplicada por 16, e deixe a conversão de cor fazer a divisão em ponto flutuante, isto é, quando a fração ainda pode ser usada.
// The division is deliberately NOT performed here. The row is handed
// to the colour stage still multiplied by 16, because rounding it to
// a byte first would throw away the fractional part that the
// conversion still needs.

#define CHROMA_SHIFT 4          /* rows carry value * 16 */

static void expand_chroma_row(Plane *plane, int py, int dst_width,
                              int stretch_x, int stretch_y,
                              unsigned short *dst) {
    int near_y = stretch_y ? (py >> 1) : py;
    int far_y = stretch_y ? ((py & 1) ? near_y + 1 : near_y - 1) : near_y;

    for (int x = 0; x < dst_width; x++) {
        int near_x = stretch_x ? (x >> 1) : x;
        int far_x = stretch_x ? ((x & 1) ? near_x + 1 : near_x - 1) : near_x;

        int a = plane_sample(plane, near_x, near_y);
        int b = plane_sample(plane, far_x, near_y);
        int c = plane_sample(plane, near_x, far_y);
        int d = plane_sample(plane, far_x, far_y);

        dst[x] = (unsigned short)(9 * a + 3 * b + 3 * c + d);
    }
}
Repara que o tipo mudou de unsigned charunsigned short
            if (smooth) {
                // The 1/16 is applied here, in floating point, so the
                // fractional part survives all the way to the colour
                // conversion.
                blue_difference = row_cb[pixel_x] * chroma_scale - 128.0;
                red_difference = row_cr[pixel_x] * chroma_scale - 128.0;
            }
Com isso o PSNR voltou a bater exatamente com a versão original, em todas as imagens e qualidades. E a velocidade continuou. 🎉
💡 A lição, e ela vale para muito além de codecs: quando um valor passa por várias etapas, arredonde só no fim. Cada arredondamento intermediário joga informação fora, e informação jogada fora não volta, o nome disso é erro de quantização acumulado, e é uma das armadilhas mais comuns em processamento de sinal.
Os resultados
Medindo cada frente isoladamente, no tempo de decode, nós temos os seguintes resultados:
Imagem    │ Artigo 20 │  + LUT   │  + DC    │ + upsampling │ Ganho
──────────┼───────────┼──────────┼──────────┼──────────────┼───────
portrait  │ 14,35 ms  │ 12,54 ms │ 11,23 ms │   8,36 ms    │ 1,72x
smooth    │ 33,02 ms  │ 33,56 ms │ 32,48 ms │  21,89 ms    │ 1,51x
texture   │ 12,23 ms  │ 11,26 ms │ 11,67 ms │   8,72 ms    │ 1,40x
micro     │ 11,85 ms  │ 12,03 ms │ 10,95 ms │   7,94 ms    │ 1,49x
Vale reparar numa coisa: as duas primeiras frentes deram ganhos pequenos e até oscilaram um pouco. O upsampling foi o que realmente moveu o ponteiro.
O que é um tipo de coisa que faz total sentido, pois era ele que estava comendo 77% do tempo.
Isso reforça a regra do artigo: se eu tivesse me empolgado com a LUT (que é a otimização mais "bonita" das três) e parado por ali, eu quase não teria nenhum ganho...
E o codec como um todo:
Imagem    │  Encode  │  Decode
──────────┼──────────┼──────────
portrait  │  5,45 ms │  8,36 ms
smooth    │ 15,48 ms │ 21,89 ms
texture   │  6,05 ms │  8,72 ms
O decode ainda é o lado mais lento, mas o desequilíbrio caiu bastante, e era mais que o dobro. Agora é cerca de 1,5×.
Agora analisando a validação completa em duas qualidades, nós temos o seguinte:
Imagem    │  q=50   │  q=85   │ Resultado
──────────┼─────────┼─────────┼───────────
smooth    │  igual  │  igual  │    OK
portrait  │  igual  │  igual  │    OK
micro     │  igual  │  igual  │    OK
texture   │  igual  │  igual  │    OK
colorful  │  igual  │  igual  │    OK
PSNR idêntico em todos os dez pontos, e os arquivos continuam exatamente do mesmo tamanho, tipo de coisa que era esperado, já que só mexemos no decoder.
Perfilando de novo o que sobrou, nós temos:
Etapa                        │  portrait  │  smooth
─────────────────────────────┼────────────┼──────────
decode_image (entropia+IDCT) │   2,20 ms  │  4,90 ms
merge_channels               │   6,09 ms  │ 17,13 ms
O merge_channels
E aqui a gente esbarra num limite. Não dá para fazer menos contas, cada pixel realmente precisa de R, G e B calculados.
A saída não é fazer menos trabalho. É fazer vários pixels ao mesmo tempo. 🤯
E é exatamente esse o assunto do próximo artigo.
Repositório no GitHub
E sim, você pode acompanhar a evolução desse CODEC de imagens em um repositório no GitHub, commit por commit 👋
Segue o link abaixo do commit desse artigo, onde implementamos a tabela de consulta do Huffman, o leitor de bits com acumulador, o atalho de bloco chapado e o upsampling em aritmética inteira:
Resumo
Recapitulando:
- O
merge_channels - A tabela de consulta resolve os códigos Huffman curtos num único acesso a array. Funciona porque um código de comprimento L cobre
2^(10-L) - Os códigos longos continuam usando o caminho lento, intacto. Otimize o caso comum, mantenha o caso raro correto.
- O leitor de bits com acumulador de 64 bits recarrega oito bytes por vez, com um caminho seguro para o fim do buffer.
- Um bloco onde só o DC sobreviveu reconstrói para uma cor chapada, isso dá para pular a transformada inteira. E quanto pior a qualidade, mais isso acontece.
- No modo 4:2:0, os pesos bilineares são sempre 9:3:3:1. A fórmula genérica em ponto flutuante colapsa em aritmética inteira.
- Arredondar o croma para byte antes da conversão de cor custou 0,15 dB. A pista foi que a imagem suave perdeu e a texturizada não. Arredonde só no fim.
- Saída idêntica: mesmo PSNR, mesmos arquivos.
- Decode: 1,7× mais rápido, e o desequilíbrio com o encode caiu de 2,1× para 1,5×.
E agora a gente chega numa fronteira interessante.
Até aqui, todas as otimizações foram sobre fazer menos trabalho: não repetir a DCT, não varrer bits um a um, não transformar blocos chapados. Mas a conversão de cor precisa mesmo calcular R, G e B para cada pixel, não tem o que cortar.
No próximo artigo, a gente muda de estratégia. Em vez de fazer menos, vamos fazer mais de uma vez só: descobrir que o processador consegue somar oito números com uma única instrução, aprender a falar essa língua, e reescrever a nossa DCT para processar as oito colunas de um bloco simultaneamente. 🤖
É onde a gente desce um degrau na direção do hardware.
Prepara o café ☕, porque o próximo é território novo.
Até lá! 👋